具身涌现 | 深度观察:短短七个月,三轮融资合计4亿美元,投后估值14.2亿美元,接近百亿人民币,腾讯、红杉中国、IDG资本、经纬创投集体押注,由清华副教授代季峰创办的Naive AI,在几乎零对外曝光的状态下搅动国内大模型赛道。
这家员工规模不足百人的初创企业,没有选择重金砸算力从零预训练大模型,而是站在已有开源基座之上做模型改造、强化学习迭代,最快本月就会对外放出开源大模型产品。
在所有人还在比拼谁拥有更大算力集群、谁能拉起千人预训练团队的时候,Naive AI走出一条看上去反常识的路线。这条路线并非国内独创,海外新兴AI实验室同样已经开始实践,但放在国内激烈内卷的大模型环境之中,它带来的讨论,远不止一笔巨额融资故事那么简单。
01
资本押注的究竟是模型还是人?
Naive AI自今年2月成立之后,一直保持极高的保密状态,官网页面仅仅留有一句品牌口号,社交账号没有发布任何对外内容,外界只能通过外媒报道与行业知情人士的信息拼凑这家公司的全貌。资本愿意在短短数月内向一家尚未对外展示产品的新企业投入巨额资金,核心落点并非已经成型的产品,而是创始人代季峰过往积累的技术口碑。
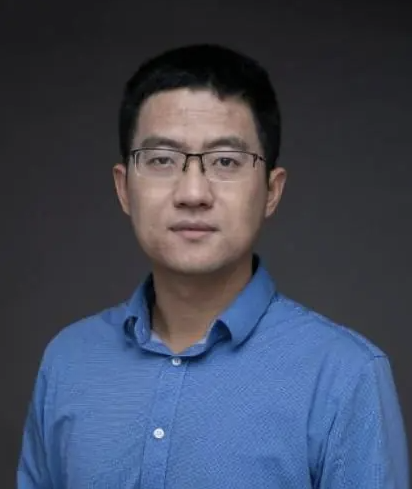
代季峰拥有完整的学术界与工业界履历,清华本博毕业之后先后任职微软亚洲研究院、商汤科技研究院,重返清华任教之后,他的研究横跨计算机视觉、基础模型与智能体方向,论文总引用超过七万次,R‑FCN、BEVFormer等研究成果长期被行业广泛使用,此前主导的InternVL开源多模态模型,也是学术界高频选用的工具。
上一段创业经历中,他参与MiroMind打造的MiroThinker智能体,在开源社区收获不少开发者认可,只是后续团队拆分,双方对于离职、知识产权授权产生分歧,走向公开对峙,这也成为他独立创业的背景。
不少一线投资机构向行业表达过自己的判断,大模型赛道走到今天,算力、数据不再是唯一胜负手,懂模型后训练、智能体迭代的顶尖人才,反而变成稀缺资源。市面上不缺开源基座,但是能够修改模型底层结构,用好强化学习、探索递归式自我改进RSI的工程团队,在国内属于少数。
具身涌现认为,资本这次下注,本质上是在为一套“后训练工程能力”买单,投资人相信创始人团队可以在成熟开源底座之上打磨出具备竞争力的模型,而不是指望团队从零完成全套预训练。
但人才背书不等于商业成功,过往学术论文、开源项目的亮眼表现,能不能平移到大模型商业产品中,仍然要等待本月开源模型正式交付之后,交由开发者与市场检验。
02
不走从零预训练,算技术捷径吗?
当下国内大模型行业,大部分主流玩家依旧坚持完整从零预训练的技术路线,搭建大规模算力集群,投入海量资金完成基础模型的通识能力构建,预训练也长期被视作大模型最核心的壁垒之一。
Naive AI放弃耗资巨大的从零预训练流程,选用国内已有的开源模型作为起点,再修改模型结构,依靠强化学习、递归式自我改进完成能力精炼,这样的选择迅速引发行业讨论,也出现了 “走捷径” 的质疑声音。
把视线放到全球市场可以看到,相似的路线已经被海外新实验室采纳。前OpenAI高管Mira Murati创立的Thinking Machines Lab发布Inkling模型,就坦诚架构大量参考DeepSeek开源权重版本;SpaceX旗下Cursor的编程模型,同样借鉴已有开源成果进行二次开发。越来越多新入局者不再执着于完整预训练全流程,转而把资源集中在中期训练、后训练、智能体闭环之上。
行业内部对此存在两种截然不同的声音。一部分研究员认为,基座决定能力上限,仅仅依靠后训练很难突破原有模型天花板,很难做出真正的下一代通用模型;另一部分从业者提出,高质量公开训练数据逐步枯竭,从零预训练的成本门槛已经抬升到普通创业公司难以承受的高度,在现有优秀开源基座基础上做深度改造,同样存在巨大创新空间,后训练本身拥有极高的技术壁垒,奖励模型设计、规避模型迎合指标的奖励漂移、防止模型发生灾难性遗忘,每一环都充满工程难题,绝非简单微调就能实现。
具身涌现认为,基于开源底座二次迭代本身不是投机取巧,真正的分界线在于,团队是否完成深度架构修改与独立训练闭环,还是仅仅做浅层微调。后训练赛道同样会面临严苛考验,如果仅仅依靠现有模型的能力红利,没有形成独有的技术沉淀,后续很容易陷入同质化竞争。
03
估值鸿沟背后,两套资本逻辑的差异
Naive AI的投后估值14.2亿美元,放在国内AI创业项目之中已经属于第一梯队,但是对标海外同类型初创企业,两者的估值体量形成刺眼差距。有消息显示,同样基于开源模型做后训练与智能体研发的Thinking Machines Lab,市场传出投前估值已经达到400亿美元级别,两者估值相差接近三十倍,两支团队技术路线却高度趋同。
这种巨大差距并不是单纯海外资本更加狂热,而是中美AI市场两套完全不一样的资本定价逻辑在起作用。美国一级市场给AI初创企业定价时,更多押注长期范式变革的可能性,畅想企业未来主导全球AI生态的退出想象空间;国内投资人做决策时,会更务实的考量商业化落地路径,关注项目多久可以通过API调用、行业方案拿到实际收入,风险定价更加保守。
Rhodiun集团相关统计数据显示,国内全部大模型企业年度经常性收入总和,大约只相当于OpenAI与Anthropic的一成,商业化天花板的预判,直接影响一级市场给出来的估值水平。即便国内部分头部大模型企业已经登陆港股,也普遍面临估值承压的现实。
具身涌现认为,估值差距不直接等同于技术实力的高下,它更像是一面镜子,照出国内AI创业客观的生存环境,国内企业要同时面对算力约束、变现压力、激烈本土竞争多重现实约束,资本会天然对远期故事保持克制。
04
后训练赛道,真的会成为行业新出口?
随着大量高质量开源基座持续释放,行业普遍感知到,大模型的竞争正在发生位移,早期比拼谁能够烧更多GPU完成预训练,而未来竞争重心,正在向中期训练、强化学习、智能体自我迭代转移。
Naive AI所押注的递归式自我改进RSI,也是OpenAI、Anthropic、谷歌这些国际巨头共同布局的方向,这套技术希望让AI模型可以自动发现缺陷,迭代升级自身能力,被视作通往高级智能体的关键路径,但目前整个行业都还处在早期探索阶段,没有成熟可大规模落地的方案。
即便赛道充满想象空间,在具身涌现看来,我们依旧不能过度美化后训练路线,这条赛道同样藏着难以绕开的现实痛点:
首先,后训练有看不见的技术陷阱,强化学习非常容易出现奖励对齐偏差,模型一味迎合打分指标,却不解决真实任务需求,如何设计稳定可靠的验证器、奖励体系,是横亘在所有团队面前的技术难关。
其次,开源基座本身存在知识产权边界,创业公司基于第三方开源模型深度改造,整个训练链路之中,技术归属、衍生成果的界定,未来会出现更多法律与商业层面的挑战,MiroMind和代季峰之间的知识产权纠纷,已经给行业敲醒警钟。
再次,人才会成为最大瓶颈,同时懂底层模型架构修改、强化学习、智能体闭环的复合型人才供给十分有限,百人的小团队能不能持续维持高强度的技术迭代,后续核心研发人员的稳定性将直接决定公司的上限。
开源抹平了预训练的入场门槛,但它不会抹平创新本身的难度。Naive AI的出现最大的价值,是给国内大模型创业打开了另一种样本,证明除了巨头式重资产预训练路线之外,还存在其他突围路径,但这条道路能不能跑通,最终依旧要看本月发布的模型真实表现。
资本可以用真金白银投票,但最终评判一家AI公司好坏的永远是开发者、是产业真实需求。当热潮褪去,真正留下来的企业,一定是那些可以把技术能力转化为实际价值的团队。