
芯片开始给模型打工
”
作者|在洲
10月29日,苏州,XHEART新芯航途发布大模型芯片X7 Ultra,大模型算力700 TOPS,NPU计算利用率实测98.7%。
Momenta CEO 曹旭东以战略合作伙伴身份登台演讲,首次将 “大模型定义芯片” 公开为 Momenta的第三大核心行业洞察。
过去五年,国内智驾芯片的叙事是中国替代,比如替代Mobileye、替代英伟达,当时比的是算力、制程以及性价比,谁能把成本做得更低、把参数堆得更高,谁就能胜出。
X7 Ultra则换了一套评价标准,700 TOPS在行业里不算炸裂,但98.7%的NPU利用率,意味着几乎每一分算力都变成了车上的实际能力。毕竟行业里标称算力很高、实际只能用掉六七成的芯片,不在少数。
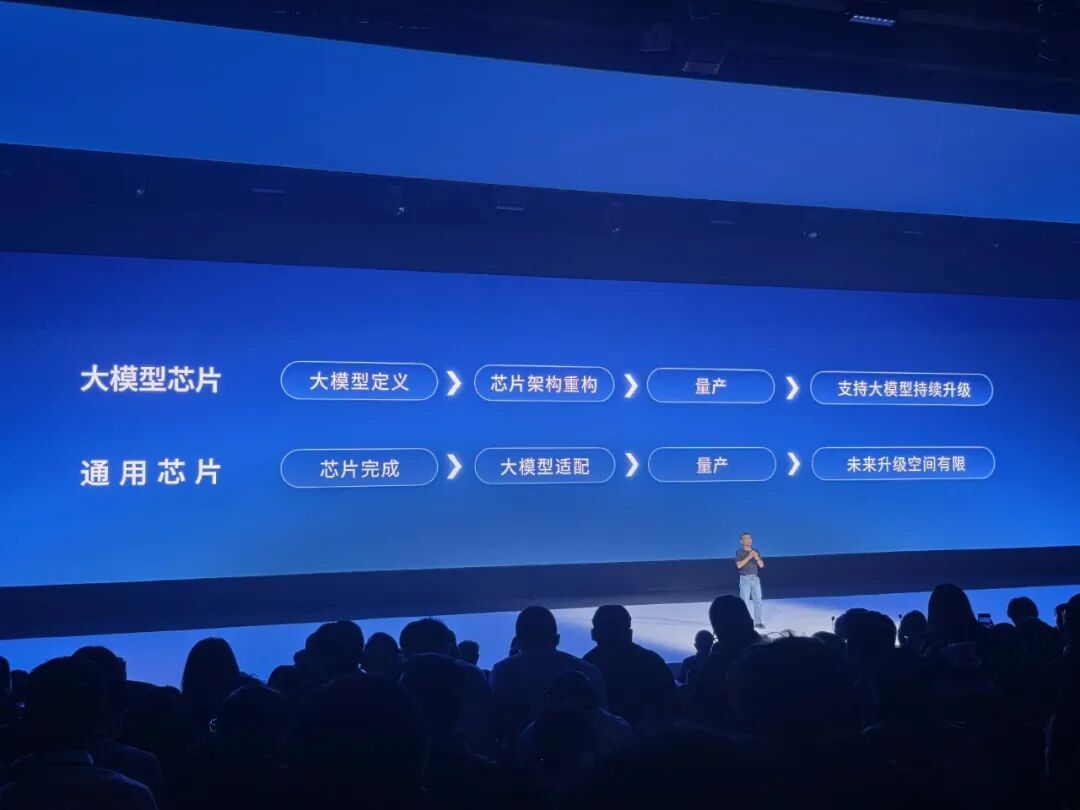
新旧评价体系变化的背后,是智驾芯片的定义权。过去是芯片公司先定架构,模型公司再想办法适配,现在是模型公司先定需求,芯片公司再去设计。如果这条路走通,它改变的不只是一家公司的命运。
而且X7 Ultra还给出了两个很难反驳的数字,量产8个月,出货超过20万颗,已搭载10款车型,拿到40多款车的订单。
01 700TOPS不是重点 98.7%才是
过去五年,智驾芯片行业的竞争始终围绕一个数字展开——峰值TOPS。
算力标称从几十到几百再到上千,数字不断刷新,但行业共识也越来越清晰,峰值算力其实不等于实际落地性能。
在传统通用NPU架构下,芯片的算力标称多基于理想工况下的峰值计算能力。但当运行Transformer结构的智驾大模型时,大量性能会消耗在数据搬运、内存读写、算子适配等环节,实际算力利用率往往仅在30%至50%区间。
这也导致很多车型标称数百TOPS算力,实际运行端到端模型时仍显吃力,算力虚标一度成为行业公开的潜规则。
X7 Ultra 的核心突破,恰恰是跳出了峰值算力的评价体系,转而以“大模型实测有效算力” 作为核心设计目标。
XHEART新芯航途李宗霖表示,该芯片采用针对Transformer 深度优化的超大核NPU架构,硬件级实现了注意力机制等大模型核心算子的加速。
同时将核内互联带宽提升至 TB/s 量级,大幅降低了数据搬运的性能损耗。
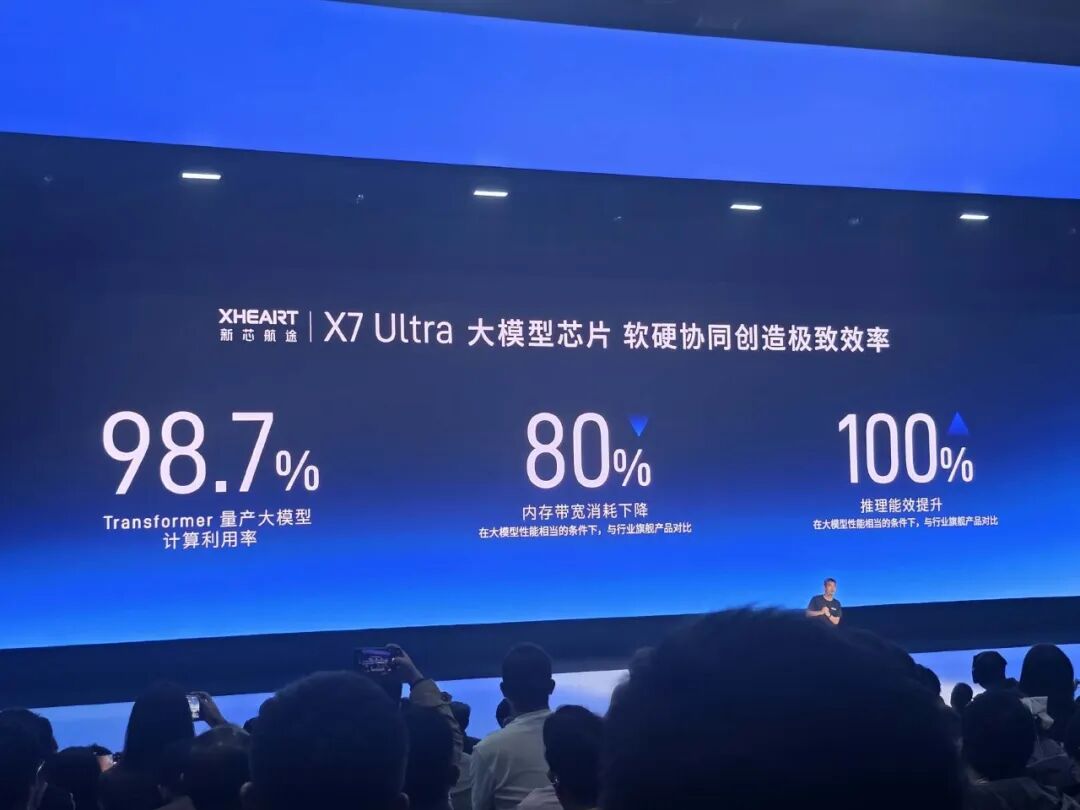
配合首发的车规级 Armv9 CPU 架构,X7 Ultra 在量产智驾大模型的实测中,NPU 计算利用率达到 98.7%。
在保持模型精度 99.99% 对齐的前提下,同等模型性能下内存带宽消耗下降 80%,推理能效较通用架构提升一倍。
这组数据的行业意义在于,它重新建立了一套大模型时代的算力评价标准。这意味着同样的 700TOPS,在专用优化架构下的实际输出能力,可能远超通用芯片标称的更高数值。
打个比方,过去行业比的是发动机的最大功率,现在比的是轮上马力,前者是实验室数字,后者才是真实上路的性能。
从技术路线看,X7 Ultra 与行业标杆英伟达 Thor 走在了完全相反的路径上。
英伟达Thor-U主打通用大算力平台,覆盖智驾、座舱、机器人等多场景,兼容各类算法框架。优势是生态完善、通用性强,代价是能效比与场景适配效率存在天然天花板。
而 X7 Ultra 选择了智驾大模型专用路线,牺牲了跨场景的通用性,换取单一核心场景下的极致能效、利用率与成本优势。
这种路线选择并非偶然。当智能驾驶从分布式算法走向端到端大模型,芯片的工作负载正在变得高度统一且稳定 —— 核心负载就是 Transformer 推理。
当场景足够聚焦,专用架构的效率优势就会被放大,这也为 “大模型定义芯片” 的路线提供了技术前提。
02 算法与芯片的双向绑定
曹旭东的站台,是这场发布会最值得解读的信号。
作为国内头部智驾算法公司的掌舵人,他很少出现在第三方芯片公司的发布会上。而此次不仅全程参与,更将 “大模型定义芯片” 上升为 Momenta 的核心战略洞察。
在发布会上的演讲中,曹旭东系统梳理了 Momenta 的三层认知递进。
第一个洞察是 “数据驱动解决长尾问题”,奠定了算法迭代的核心逻辑。第二个洞察是 “规模量产获得海量数据”,推动 Momenta 走上前装量产的飞轮路线,用规模化数据反哺算法。而第三个,也是当下最新的判断 ——大模型定义芯片。
在曹旭东看来,当智驾模型演进到端到端、百亿乃至千亿参数级别,通用芯片会陷入 “不可能三角”。
无法同时满足车规级的可靠性、低功耗与低成本要求。
唯有从大模型的真实需求出发,反向定义芯片的计算、存储与互联架构,才能在车端严苛的约束下,支撑更高阶的智能驾驶能力。
他给出的判断是:大模型专用芯片相比通用芯片,综合性能可提升10倍。
这套逻辑并非停留在口号层面,XHEART本身就是这套方法论的产物。
公开信息显示,XHEART 创始团队核心成员脱胎于Momenta 内部芯片部门,公司独立运营后,Momenta 及曹旭东等核心成员通过持股平台间接持有股份。
双方的关系远非简单的客户与供应商,而是深度绑定的协同体。
Momenta 负责定义芯片的需求与场景,XHEART 负责硬件设计与量产落地,芯片迭代与算法迭代同步推进。
这种 “算法公司孵化芯片公司” 的模式,在国内智驾芯片行业独树一帜,也带来了远超行业平均水平的商业化落地速度。
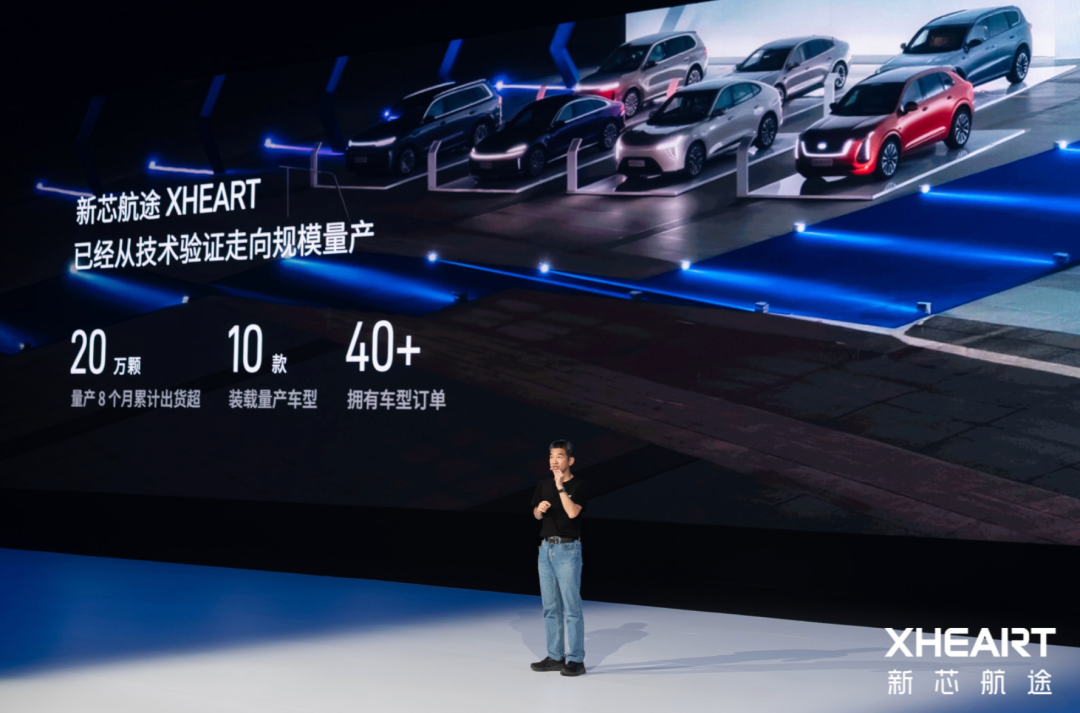
据发布会披露,X7系列芯片自今年初量产以来,8 个月时间累计出货量已突破 20 万颗,搭载于 10 款量产车型,获得超过 40 款车型的定点项目。
对于一家成立仅两年的芯片创业公司,这个速度在行业内极为罕见,当然,也离不开Momenta 积累的车企客户资源与量产经验的直接导流。
资本层面同样印证了产业对这条路线的认可。
成立两年间,XHEART已完成4轮融资,累计融资额近50亿元。股东阵容覆盖上汽、奇瑞、雷诺等整车企业,长鑫科技等上游供应链企业,以及头部 VC 与国资产业基金。
车企下场投资的逻辑清晰可见,通过深度绑定定制化芯片,摆脱对英伟达单一供应链的依赖,掌握智驾硬件的成本与迭代主动权。而长鑫的入局,则预示着 “存储 - 计算” 协同优化的供应链整合趋势。
但硬币的另一面,是这套模式天然的边界争议。
深度绑定 Momenta 既是 XHEART 的护城河,也可能成为其增长的天花板。一个无法回避的问题是:其他智驾算法厂商,是否愿意采用一家由竞争对手深度参与的芯片方案?
如果 XHEART 的客户始终以 Momenta 生态为主,它最终可能沦为Momenta 的专属硬件部门,而非一家独立的第三方芯片公司。
这是其接下来必须回答的商业化命题。
03 专用芯片能打破通用范式吗?
X7 Ultra 的发布,正式将中国智驾芯片的竞争拖入了下半场。如果说上半场是通用算力的参数比拼,下半场则是软硬协同与路线选择的较量。
目前国内智驾芯片市场,三条技术路线的分野已经清晰。
第一条是英伟达主导的通用大算力路线,凭借完善的软件生态与强大的通用性能,占据高端车型的主流位置。但其高昂的成本与供应链的不确定性,也让车企始终有替代动力。
第二条是以地平线、黑芝麻为代表的国产通用NPU路线,兼顾多场景适配与性价比,依托本土化服务快速抢占中低端市场,走的是 “通用架构 + 本土化生态” 的替代路径。
第三条,正是XHEART代表的大模型专用路线,深度绑定头部算法公司,走垂直整合的极致效率路线。
这条路线的核心逻辑是,当大模型统一了智驾的算法范式,专用架构就能用更低的成本、更高的效率,实现同等甚至更好的性能。
但这条路线同样面临行业争议,首先就是技术迭代的错配风险。
众所周知,大模型算法的迭代速度远快于芯片研发周期,算法可能半年就完成一次架构革新,而一款车规芯片从定义到量产通常需要2-3年。
今天为当前Transformer架构深度定制的硬件,会不会在量产后不久,就跟不上算法的迭代节奏?
XHEART 在发布会上称,芯片架构为未来模型演进预留了足够的灵活度,但这种灵活度能覆盖多大的技术变数,仍需要时间验证。
一旦未来大模型架构出现颠覆性变化,专用芯片的适配成本可能远高于通用架构。
再有就是生态的天然短板。通用芯片的核心壁垒从来不是硬件本身,而是软件生态。所有算法厂商、所有车企都可以基于这套平台做开发,生态的网络效应会不断强化其优势。
而专用芯片从诞生起就绑定了特定算法,生态天然狭窄,很难吸引第三方开发者与客户。这也是为何英伟达的通用范式能统治行业多年的核心原因。
值得注意的是,这场算力军备赛还在加速。
发布会上XHEART披露了下一代产品X9的规划,预计2027年量产,单芯片大模型算力达到 3000 TOPS,内存带宽 700GB/s。
目标是支撑千亿参数级别的端到端大模型在车端运行。
这意味着,车端大模型的算力门槛正在以远超预期的速度抬升,芯片厂商的迭代节奏正在向算法公司靠拢。
从更大的产业视角看,X7 Ultra 的出现,是中国智能驾驶产业从应用层向上游核心硬件延伸的一个缩影。
过去几年,中国公司在智驾算法、数据量产层面追上了全球第一梯队,如今这种优势正在向芯片、存储等上游环节传导。
这条 “算法反向定义芯片” 的路线最终能否走通,现在下结论还为时尚早,但它可能会成为打破英伟达通用范式的突破口。
而且可以确定的是,智驾芯片的竞争已经告别了简单的数字游戏。
真实场景的效率、软硬协同的迭代速度、全栈可控的供应链能力,正在成为新的胜负手。
对于中国汽车产业而言,多一条路线的探索,就多一份在智能驾驶时代掌握核心话语权的可能。