
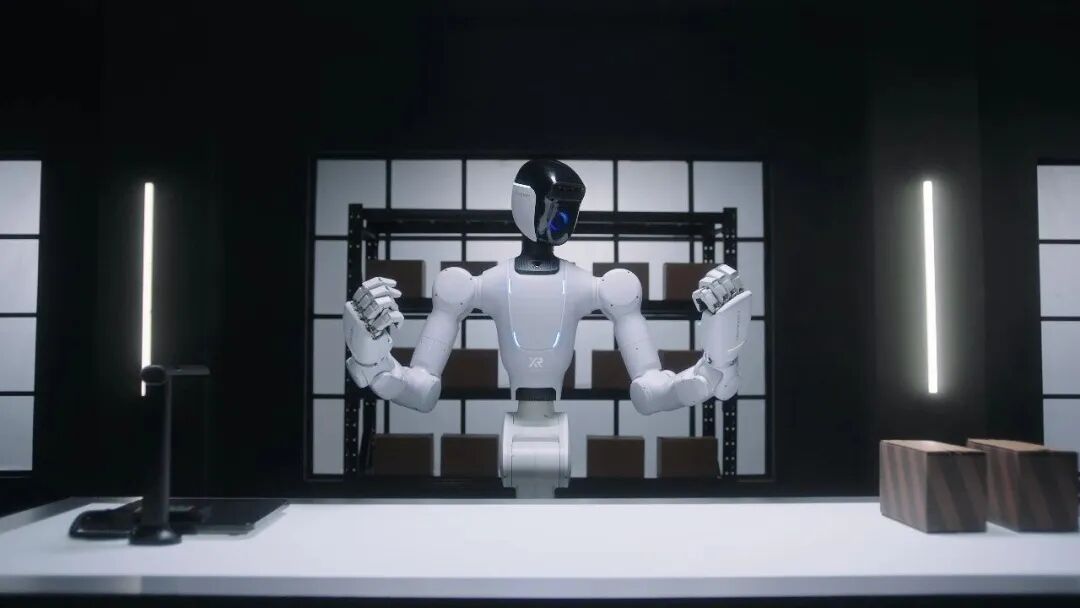
具身智能告别“炫技”,从单点能力验证走向系统能力构建。
最近具身智能行业又热闹起来了。
6月29日,自变量机器人宣布B+至C轮四轮融资全部交割,投后估值突破200亿元,成为大湾区首个摸到这条线的具身智能企业,美团、阿里、字节、小米四大厂分别领投了一圈。
6月30日,北京智源孵化的星源智与电动叉车龙头中力股份联合打造的具身装卸解决方案正式全球发售,搭载RoboBrain Pro的无人叉车单车作业压到90秒、双车协同1分钟,装卸效率追平人工。
一边是资本给"通用具身大脑"标价200亿元,一边是"具身大脑+工业本体"把无人装卸第一次压进工业节拍,具身智能告别“炫技”,从"能做"迈向"能用",从单点能力验证走向系统能力构建。

90秒的“实证”RoboBrain Pro发售,无人装卸首次追平人工
很多人对物流装卸的落地难度没有概念,传统自动化装卸方案推了十余年始终没能大规模普及,核心卡点就在于真实场景的 “非标准化”:货车每次停靠的位置都有偏差,货台高度不是统一数值,集装箱内部光线昏暗、识别难度大,稍有不慎就会出现货叉对位不准、货物磕碰的问题。
过去的方案是典型的 “分段式作业”:感知模块识别车辆位置,规划模块算好路径,控制模块执行动作,每个环节之间是割裂的,遇到偏差就要停下来重新规划,一次装卸要三四分钟,效率不到人工的一半,还经常因为环境变化卡壳,客户自然不愿意买单。
RoboBrain Pro 带来的改变,是用 “具身大脑 + 车载小脑” 的协同架构,把原来割裂的环节全部打通成一条连续的作业链。路端的多模态感知先把货车边界的标定误差从行业普遍的 0.77 米压缩到 0.1 米,在动态的非标准停车场景下快速搭起厘米级的空间坐标系;
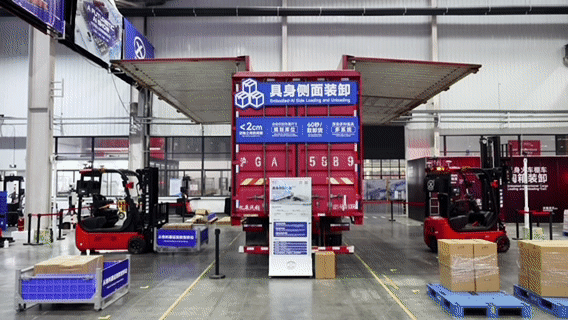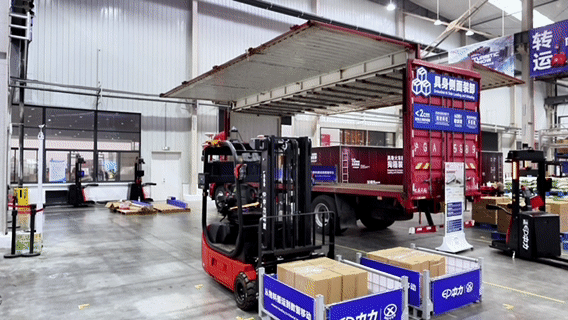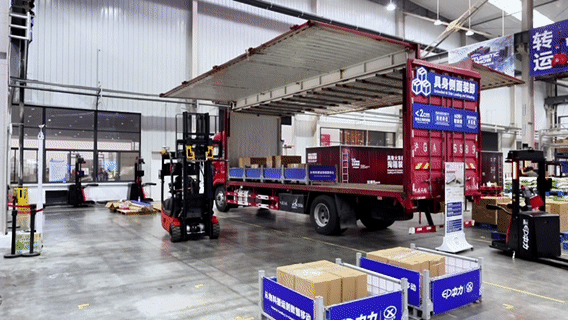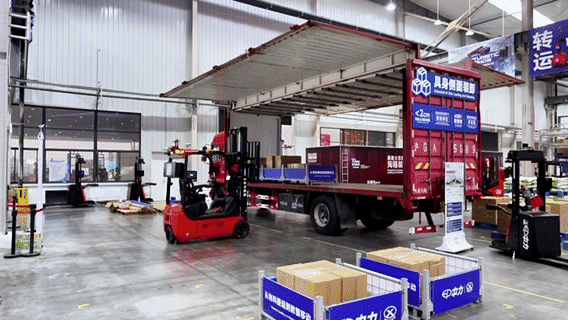
具身大脑做统一调度,把原来 “识别 - 停 - 规划 - 停 - 执行” 的分段流程,重构为没有停顿的连续动作链,把等待和重复规划的时间损耗全部挤掉;到了最关键的货叉对位环节,端侧视觉会实时捕捉托盘孔位和货叉的偏差,在行进中做 1-2 厘米级的动态纠偏,不是追求 “一次对准”,而是像人工作业一样,边走边调整,动态收敛到准确位置。
无人叉车原来要3分钟,现在单车90秒,双车协同能压到1分钟,靠的不是哪一模块的单独提速,而是大脑层面统一调度感知、规控和末端闭环的结果。
相较于地面装卸场景,高位作业对空间理解精度、路径规划能力与安全冗余机制提出更高要求。RoboBrain Pro在该系统中继续承担统一决策中枢作用,使设备能够在复杂立体空间中完成目标识别、路径规划与作业执行,并在非标准工况下通过遥操作机制实现人机协同补充。
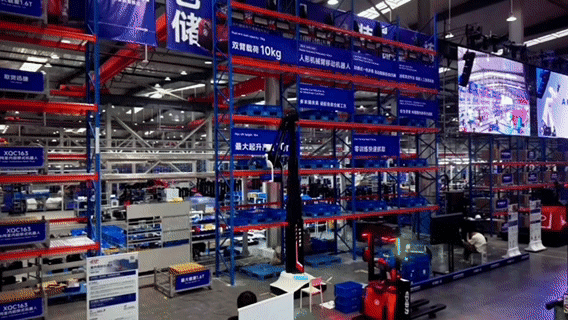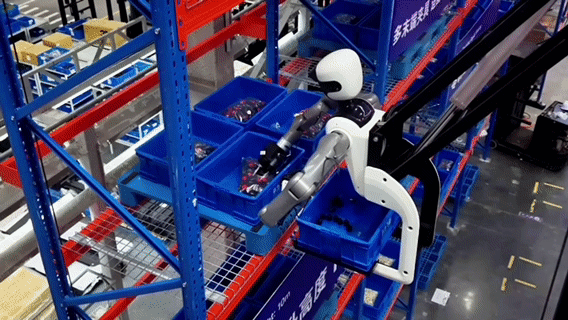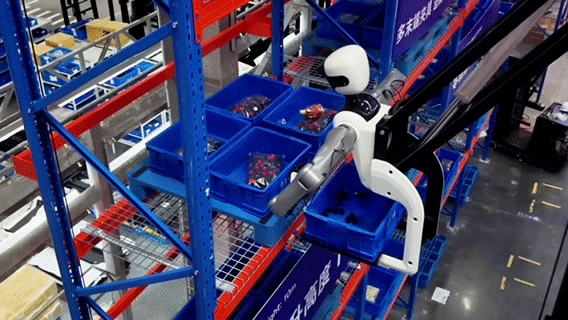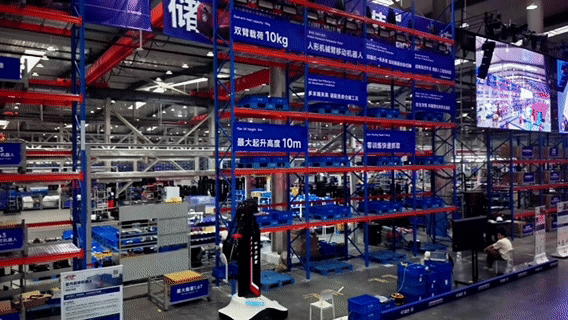
这与银河通用的打法逻辑相似,银河通用同样是自研大脑起家,银河星脑打通了大脑小脑神经控制的端到端链路,但它没有停在实验室里讲通用性的故事,而是先扎进工业、零售、医疗这些具体场景,拿下宁德时代、博世、丰田这些客户的实单,累计订单数千台。
这类玩法可以叫场景锚定型大脑派。技术自研,但商业化的第一步,是找一个确定性最高的垂直场景,用真实交付把大脑的能力坐实,然后再横向复制。

200亿的“定价”自变量融资落定,具身大脑开启马太效应
如果说星源智的 90 秒是垂直场景里 “产业绑定 + 深度优化” 跑通的样本,自变量拿下的 200 亿估值,就是资本市场给 “通用具身大脑” 路线投下的信任票。
自变量从成立第一天起就走全栈自研的通用路线,要做的不是适配某一个场景的定制化系统,而是能适配不同本体、不同场景的通用具身智能底座。
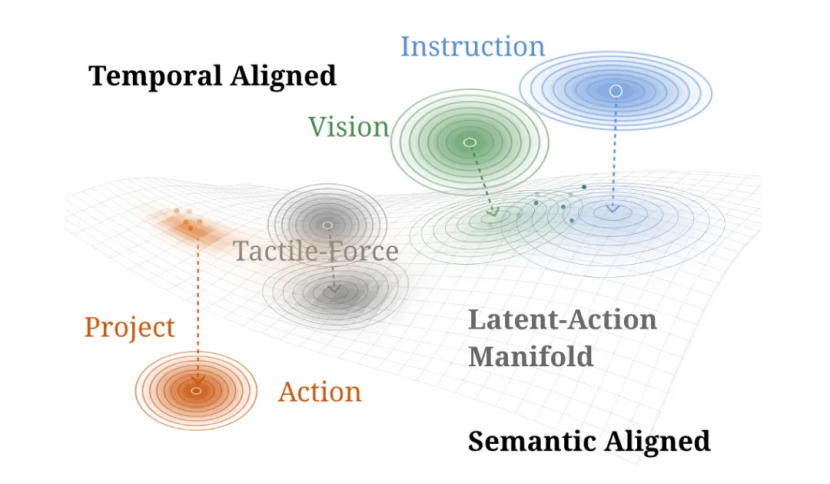
今年 4 月发布的 WALL-B 大模型,是全球首个基于 “世界统一模型” 架构的原生多模态具身大模型,和行业普遍把视觉、语言、动作模块拼接起来的 VLA 架构不同,WALL-B 把所有能力放到同一个神经网络里从零联合训练,彻底消除了模块之间的数据搬运损耗,让机器人能像人一样整体感知、整体决策,反应速度达到毫秒级。
在此基础上,他们又推出了开源模型 WALL-OSS 0.5,仅靠预训练就能在多个真机任务里达到 80% 以上的完成率,超过了很多经过后训练的主流模型;还有全球首个 “事件级” 世界模型 WALL-WM,不再按固定时间切片采样,而是通过 “事件” 对齐多模态数据,能像人一样预测物理世界的变化,提前做出判断。
比模型突破更重要的是工程化能力的闭环。具身智能行业卡了很多年的核心瓶颈之一,就是真实世界的数据采集成本太高,人工标注动作序列难度大、成本高,复杂场景和罕见场景的数据更是难以获取。
自变量自研的工业级数据管线,加上 XR Zero 无本体数采方案,把模型训练需要的数据成本直接降了95%,还能通过数据合成复现危险、罕见的场景;自研的分布式训练和推理框架,把训练吞吐和推理延迟做到了行业领先,甚至在开发者大会上,参赛选手只用三天就完成了从数据采集、模型训练到真机部署的全流程,而过去专业实验室做同样的事至少需要六个月。
这种从模型、数据到 Infra 的全栈能力,是支撑通用大脑跨场景落地的基础。
这轮融资的阵容值得一看。自变量是国内具身智能企业里,唯一一家被美团、阿里巴巴、字节跳动、小米四大互联网厂商分别领投过的公司,而且不是投一次就走,小米战投一家就连着投了三轮。
互联网大厂平时在牌桌上互为对手,这次难得在同一家创业公司身上达成共识,还愿意多轮加注,这背后是一种共同判断。
但用更挑剔的眼光看,一家主营业务还在试点阶段的模型公司,跟已经量产盈利、马上要上市的宇树放进同一个估值梯队,多少有点不公平,自变量手里还没有宇树那样的出货量和现金流支撑。顶级资本愿意托举自变量到200亿,押注的不是机器人出货量这种能直接数出来的数字,而是这颗大脑本身的泛化能力,一个短期内很难被证伪也很难被证实的命题。
为什么资本现在愿意为一家纯粹的大脑公司开出这个价格?行业里正在形成一个新共识,机器人的本体技术已经卷到极限,硬件层面各家的差距在缩小,真正决定一台机器人能干多少种活的,是那颗大脑。本体决定它能做出动作,大脑决定它知不知道该做哪个动作。这个共识一旦成立,纯泛化能力本身就有了独立于场景交付的定价权。
还有一层背景不能忽略。今年初智谱和MiniMax相继在港股上市,二级市场给大模型公司的估值极高,这套估值逻辑很快传导到一级市场,带动了对具身大脑标的的重新定价。
投资人开始用更长期的视角看这个赛道,愿意相信未来几年高达百分之几十甚至翻倍的年化增速,用这种想象力去消化眼前的高估值。自变量的200亿,某种程度上是大模型公司的估值范式,提前预付给了一家还没交出规模化答卷的具身大脑公司。

场景派和泛化派,殊途同归
把星源智银河通用这一类和自变量放在一起看,其实是资本对具身大脑的两种定价方式。
场景锚定型大脑派用交付换确定性,每一单真实订单都是对大脑能力的一次背书,估值涨得慢一些,但每一步都踩得比较实。
纯泛化型大脑派用时间换空间,不给自己设边界,一旦泛化能力真正兑现,打开的市场想象空间会更大。
行业里现在已经有至少九家公司跨过百亿估值门槛:宇树、智元、银河通用、星海图、自变量、星动纪元……仔细看会发现,几乎所有头部公司最终都要回答同一个问题,大脑到底能不能在没有人为它划定边界的地方,自己判断该做哪个动作。
星源智从粗定位走到厘米级标定,靠的是场景里磨出来的数据和信任。自变量从A轮到200亿走了两年多,用的是资本对通用性这件事的持续加注。
两条路线看似不同,实则殊途同归。如今,具身智能行业正经历从“单点能力验证”到“系统能力构建”的关键转折,就像星源智创始人兼CEO刘东在采访中提到:“过去行业关心机器人能否完成某个动作,现在的竞争焦点是,系统能否在真实、动态、非结构化的环境中,持续稳定地完成复杂任务链。”
这道题,谁先交卷,谁就先拿到定义下一代生产力入口的资格。

编辑:木人 审校:张问心 制作:瑞总