
2026年7月31日,DeepSeek 正式推出 V4-Flash 正式版API 并开启公开公测,这也是今年4月V4系列预览版上线后,该模型迎来的首次重大版本能力升级。
图源:财联社
本次更新聚焦Agent智能体能力,在不改动模型架构与参数规模的前提下,实现了全方位性能跃升,多项实测数据刷新国产轻量化模型纪录。
本次升级有一个非常关键的事实前提:V4-Flash 正式版与此前预览版模型结构完全一致。依旧采用 MoE 混合专家架构,保持2840亿总参数、130亿激活参数、100万超长上下文规格,全程无扩容、无架构迭代,仅通过精细化后训练优化,完成能力跨越式升级。
同时官方明确说明,本次更新仅针对 V4-Flash API 生效,现阶段 V4-Pro 预览版、网页端与 App 模型均未同步更新。
本次升级最核心的变化,是Agent 智能体实操能力大幅增强。官方公布的9项专业基准测试数据,全部真实可查,提升幅度十分直观。
在终端实操能力测试 Terminal Bench 2.1 中,模型得分从预览版 61.8 提升至 82.7,终端运维、设备操作、指令执行等实操能力大幅提升。在核心代码能力场景,DeepSWE 代码仓库理解与修改得分从 7.3 暴涨至 54.4,涨幅超6倍,可独立完成复杂项目读码、改错、迭代开发工作。
其余专项实测数据同样亮眼:网络安全专项 Cybergym 得分76.7,工具调用专项 Toolathlon-Verified 得分70.3。针对2026年全新上线、贴合真实职场任务的两大智能体综合评测,Agent Last Exam 得分25.2、Automation Bench Public 得分25.1。在全栈开发、高难度编码测试中,分别拿下 68.7、59.6 的高分,整体实力全面超越此前的 V4-Pro 预览版。
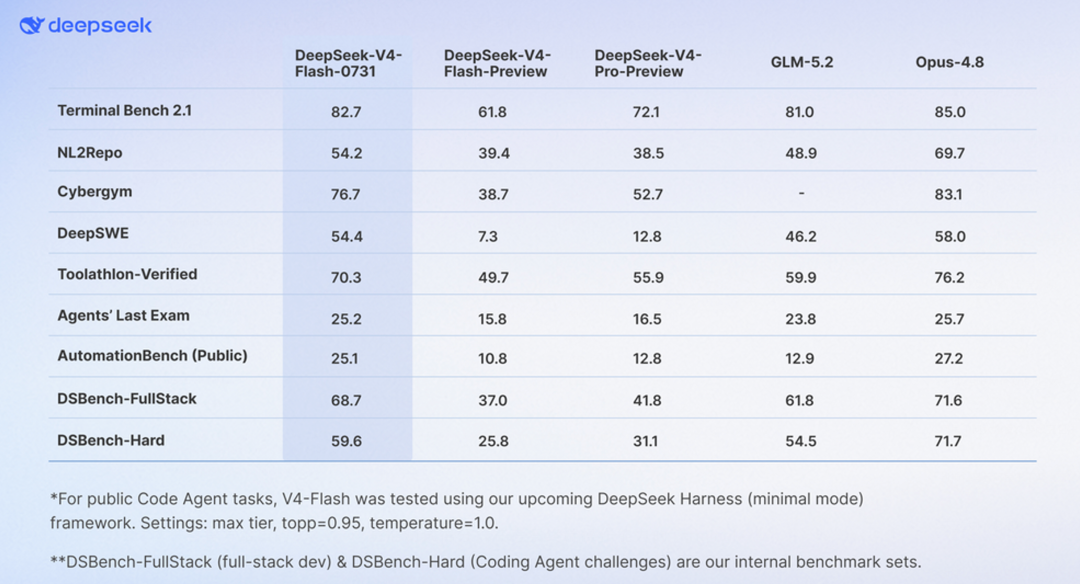
图源:deepseek
本次升级后,两大权威AI评测平台同步更新榜单数据,客观印证模型综合实力。Artificial Analysis 智能指数显示,V4-Flash 正式版得分50分,较旧版提升10分,仅落后 GPT-5.6 Luna(51分)1分,成功跻身全球第一梯队。
本次 V4-Flash 为轻量化 MoE 模型,官方横向对标国产 GLM-5.2、海外 Opus 4.8 两大主流模型。GLM-5.2 拥有7440亿总参数、400亿激活参数,参数规模远高于 V4-Flash。在本次升级重点优化的Agent、代码、终端实操专项基准测试中,V4-Flash 正式版表现优于 GLM-5.2,整体综合性能逼近 Opus 4.8,是国产轻量化模型中的优质水平。
除性能升级外,本次更新的极致性价比是最受开发者关注的核心亮点。V4-Flash 正式版 API 定价公开透明:输入 0.14 美元/百万Token,输出 0.28 美元/百万Token,缓存场景调用价格极低。
横向对比行业主流模型,成本优势明确:官方数据显示,即便 OpenAI 将 GPT-5.6 Luna 降价80%,V4-Flash 单任务调用成本仍低60%,相较 Claude Opus 4.8 具备显著价格优势。网传同款自动化代码任务的速度对比为第三方实测参考,仅作参考,非官方标定数据。
在 Arena.ai 前端代码跑分榜单中,V4-Flash 以 1586分 更新榜单成绩。申万宏源、国联民生证券发布研报点评:V4-Flash 具备轻量化、高性能、低成本的特点,夯实国产AI性价比优势,能够降低AI应用落地门槛,利好AI应用产业链发展。
结合官方说明与实测体验,本次升级的适用场景与客观局限也十分清晰,全部为事实呈现。能力层面,本次升级红利集中在代码开发、终端运维、工具调用、网络安全等专业生产力场景,通用文案创作、创意生成、复杂推理等场景提升有限,并非全场景通用型模型。
使用层面,新版高阶能力目前仅对API开发者开放公测,普通用户无法在网页端、App 体验最新升级效果,大众感知较弱。同时本次高分数据主要对标自家旧版预览模型,相较于尚未发布的 V4-Pro 正式版,仍存在一定性能差距。
整体来看,本次 DeepSeek V4-Flash 正式版升级,是一次针对性的能力优化迭代。在不改动模型架构与参数的前提下,通过后训练优化,显著提升了Agent与代码实操能力,同时具备突出的成本优势,为国产轻量化AI模型的迭代与落地应用提供了新方向。
互动留言
你是否体验过 DeepSeek V4 系列模型?你觉得本次升级对AI开发落地帮助大吗?
免责声明:本文仅为智财经评论,不构成任何投资建议。文中涉及的企业数据、监管事件均来自公开信息,仅供参考,具体以官方发布为准。图片来源网络,如有版权,请联系删除。
欢迎在评论区留下你的想法!
AI智能财经洞察每日见