最近,KubeCon + CloudNativeCon + OpenInfra Summit + PyTorch Conference China大会在上海举办,这可能是开源行业有史以来名称最长的一场大会,甚至一口气都念不完。但这个名字本身,恰恰道出了AI产业当下最重要的一次变化:当下AI行业,需要CNCF、OpenInfra、PyTorch三大开源基金会更多合作,以满足行业变化需求。
在9月8日的媒体发布会上,OpenInfra基金会总经理Thierry Carrez(阚雷)、CNCF 执行总监,Linux 基金会云与基础设施执行总监Jonathan Bryce(傅兰石)、PyTorch基金会执行总监Mark Collier(科理怀)首次并排坐在了一张采访桌前。
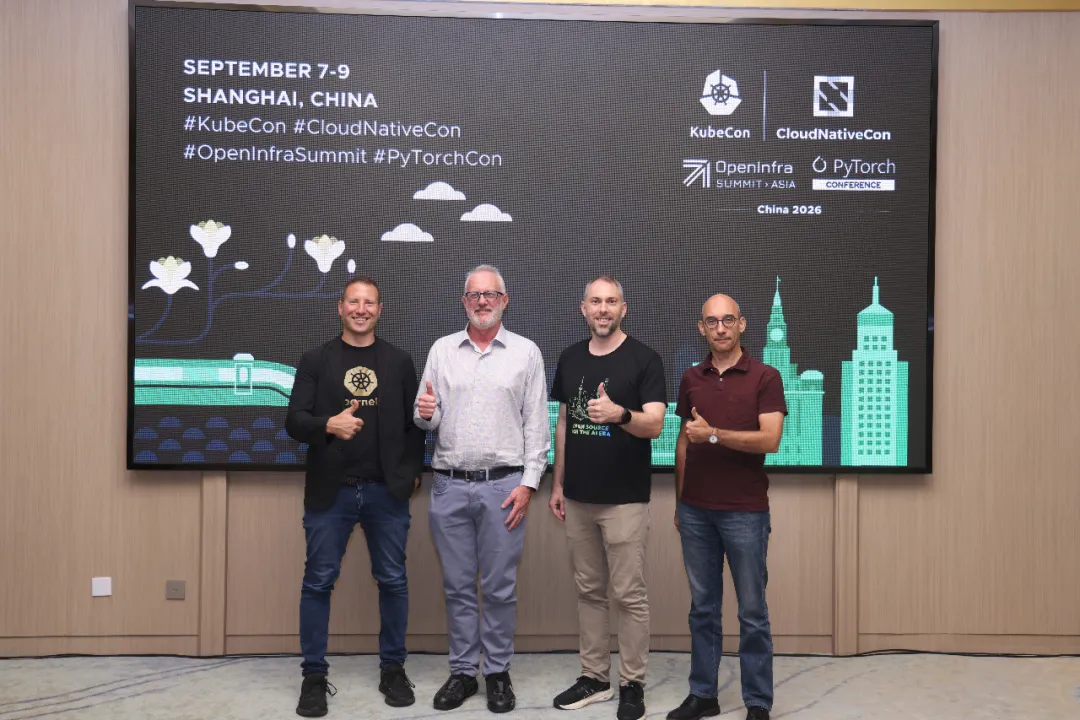
这不是一次偶然事件。过去几年,开源世界各基金会边界清晰、各司其职:OpenInfra管底层硬件资源,CNCF管应用编排调度,PyTorch管模型训练推理。让它们走到一起的,是今天的AI落地方式的根本性变化。
当前,一个AI推理请求可能需要同时调动GPU调度、KV Cache、高速网络、vLLM和Kubernetes,任何单一层面的技术都不再适合独立成章。
在这场媒体采访沟通活动中,来自三大基金会的负责人一起回答了三个问题:为什么三大开源社区现在走到了一起?当下的AI进入生产环境之后,企业的基础设施需要哪些合作?开源又能解决哪些难题?
一、AI落地的瓶颈,正从模型转移到系统
过去三年,AI行业的关注点被大模型牢牢占据:参数规模、训练卡数、跑分纪录是大家关注最多的热点。但是在2026年,当企业开始真金白银地为AI付账时,大家关注的焦点发生了偏移。
Mark Collier在发布会上给出一个判断:AI正在从模型时代进入系统时代。模型虽然依然重要,但真正决定企业AI效率的,是模型下面那一整套系统能否协同工作。只有构建开放的系统,才能让社区和生态充分交流,模型才会以越来越快的速度迭代,从每年更新,变成几乎每天更新。
Thierry Carrez也认为"AI始于基础设施",并带来一组数字:全球生产环境中OpenStack核心实例已突破5500万,其中76%采用Linux、OpenStack、Kubernetes组成的完整技术蓝图;2026年的用户调研显示,三分之一的受访者已在生产环境用OpenStack承载AI/ML业务。基础设施层非但没有被AI取代,反而因AI获得了第二增长曲线。
Jonathan Bryce则把云原生社区定位为AI的"运营层"。硬件底座决定AI能不能跑起来,运营层决定的是AI能不能大规模、可观测、可信赖地跑。他带来两个颇具说服力的中国案例:拥有亿级用户的招商银行,基于Kubernetes以及Kueue、KEDA、HAMi、Fluid等CNCF开源项目搭建统一控制平台,用上万张异构加速卡支撑训练、微调和在线推理,将纳入平台管理的加速计算资源比例提升至99%,平均利用率从35%提高到60%以上,每百万Token推理成本下降超过60%。阿里云则以CNCF毕业项目Karmada作为统一多集群编排平面,支撑通义千问的大规模推理基础设施,横跨数十个异构Kubernetes集群完成分布式推理,GPU利用率提升25%—30%,系统可用性达到99.99%。
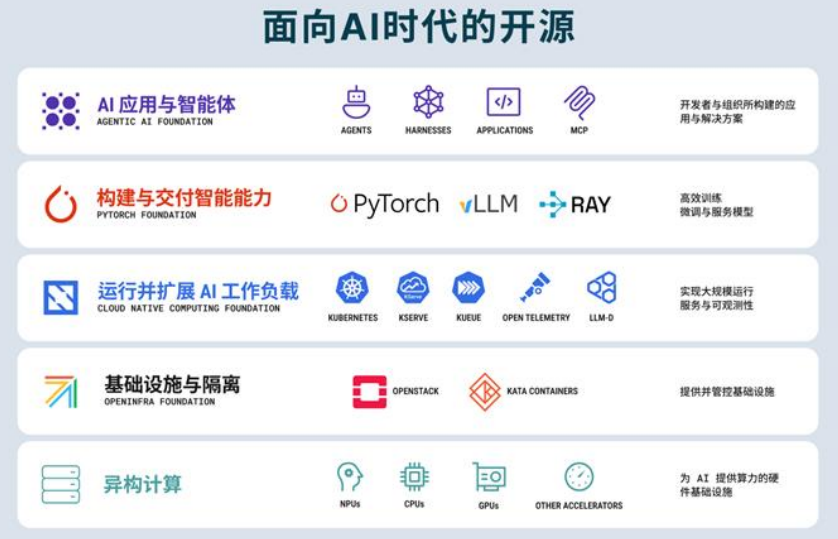
如今,GPU价格昂贵,大量GPU长期等待数据、等待调度、等待其他任务完成,是当下企业AI账单上最刺眼的浪费。GPU利用率正在成为衡量AI基础设施水平的硬指标,这就需要三大基金会来配合,更好的提升系统对硬件的利用率。
二、Agent改写负载规律,统一软件层成为必答题
三大基金会的合作,已经成为AI时代的必然。CNCF 首席技术官,Linux 基金会云与基础设施 CTO Chris Aniszczyk在发布会上也说得很直白:"一个项目无法解决所有问题,一个基金会同样无法解决所有问题。"这意味着开源世界延续多年的"分封而治"格局,正在被AI的生产化进程打破。
如果说"系统时代"是这场联手的总背景,那么真正推动三大基金会坐到一起的,是两条同时发生的暗线:负载侧,Agent正在重写数据中心的工作负载物理学;供给侧,硬件的多元化正把软件推向碎片化的深渊。
我们先看负载侧。Jonathan Bryce指出,AI应用与传统应用存在两个本质差异。
第一个在硬件:传统服务器大体是CPU、内存、存储、网络四要素,而AI系统里硬件组合空前复杂。GPU、NPU和各类专用加速器并存,配上HBM、DRAM、高速SSD和复杂的高速网络。更关键的是,一个AI任务不再从头到尾跑在同一种硬件上。AI基础设施不能只盯着GPU,而必须把CPU、GPU、内存、存储和网络当成一个完整系统来优化。
第二个差异来自Agent。过去数据中心的工作负载由人产生:点击、输入、提交,行为大体可预测。Agent完全不同,它接受任务后自行拆解、调用工具、访问数据库、并行发起子任务,再根据结果生成新的请求。Jonathan分享,维基百科有35%的访问由Agent驱动模式产生,却消耗了超过60%的资源,机器开始自己制造大量的工作负载。
再看供给侧。硬件多元化已是既成事实,中国市场尤其突出:大量AI芯片公司进入数据中心,GPU、NPU、DCU及各类边缘芯片层出不穷。问题随之而来:如果每出现一种新芯片,就要重新适配模型、推理框架、调度系统和开发工具,整个AI产业将沦为互不兼容的孤岛。Mark Collier在发布会上立下的原则,正是对这条暗线的正面回应:"硬件可以越来越多,但软件不能跟着越来越碎。"
这两个因素就导致一个产业难题:负载越来越不可预测,硬件越来越多元,如果软件层再跟着碎片化,AI规模化落地就是一句空话。解法只有一个,让任何模型都能运行在任何芯片、任何云和任何基础设施之上。这正是PyTorch基金会给自己定的目标。
如今,PyTorch在这方面一直积极努力在做,已经拥有约12000名社区贡献者,由NVIDIA、华为、Intel、AMD等数十家厂商共同维护;vLLM作为领先的开放推理引擎,一年内贡献者数量增长超过280%,拥有2000个参与组织。众多厂商把各自硬件的适配能力贡献到上游,形成复利式增益,而不是每家企业重复造轮子。
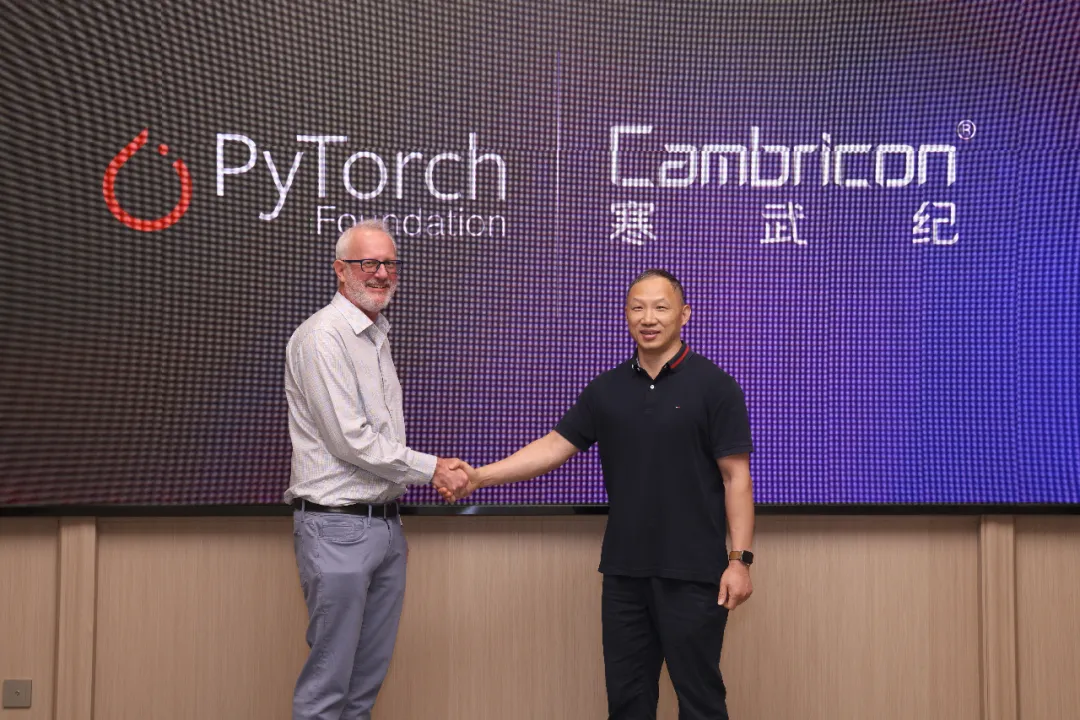
这个"统一软件层"的逻辑,甚至重新定义了AI芯片公司的交付物。今天做AI芯片,交付的早已不是芯片加驱动程序。还要回答一连串问题:PyTorch能不能跑、主流模型能否方便部署、vLLM能否支持、Kubernetes能否调度、企业现有软件栈能否直接使用。开源软件由此成为连接不同AI硬件的一层公共基础设施。发布会上,寒武纪签约加入 PyTorch 基金会,其融入全球市场,对中国用户来说无疑是个巨大的好消息。
当然,统一不代表无界。Agent自主执行代码带来的安全风险,正是软件层必须补上的另一块拼图。蚂蚁集团的实践已经走在前面:基于Kata Containers、Agent Sandbox与Kubernetes,为智能体负载搭建了硬件级强隔离环境;越南电信Viettel则依托OpenInfra底座叠加云原生GPU管理、PyTorch与vLLM生态,把裸金属异构加速器资源池做成了多租户Token-as-a-Service推理平台。统一的是底座,隔离的是信任边界,这两件事,缺一件都撑不起生产级AI。
三、开源首选遇上芯片多元,中国站上系统时代试验场
三大基金会负责人在发布会上不约而同地强调中国市场,这不是客套。一方面,中国企业对开放模型和开源AI技术的采用异常积极。Jonathan分享道,与一些市场习惯直接采购闭源AI服务不同,中国公司把开源作为第一选项。另一方面,中国拥有全球最活跃的硬件创新生态,大量AI芯片、服务器和数据中心厂商在此竞逐。
这两股趋势正在汇合成独特的"中国变量":下面是越来越多样化的AI硬件,上面是越来越丰富的开放模型,中间迫切需要一个开放、标准的软件栈把它们连接起来。中国企业正在用自己的生产实践验证这套逻辑——蚂蚁的强隔离智能体基础设施、招行的统一异构算力平台、阿里云的多集群推理,都是世界级规模的真实负载。
人才与社区的数据同样说明中国在这方面的力量:如今中国已有约175万云原生开发者,其中近40万专注AI流水线;OpenInfra全球11万社区成员中10%来自中国,已是全球第三大社区力量;中国是PyTorch全球第二大贡献群体,超过100位中国开发者向上游贡献代码,vLLM若以国别统计开发者数量,中国已与美国持平。本届大会上,Cloud Native Community China(CNCC)宣布成立,阿里云成为Platinum会员——从用户到贡献者、从消费者到共建者的路径,正在中国加速走通。
结语:
如今,一个基金会搞不定AI了,这场联手的终点,不是三场大会并成一场,而是把"任何模型、任何芯片、任何云、任何Agent"做成一层事实标准:OpenInfra筑牢底座,CNCF负责运营,PyTorch守住中立标准,共同构成AI时代的计算公共层。
而决定终局的,是"学习速度"。Mark Collier在发布会结束时说:信息流得越快,系统学得越快。翻译成产业竞争的逻辑就是:封闭的栈只能靠自己更新,开放的栈可以让全世界的开发者和硬件厂商替它更新。这就是三大基金会必须走到一起的根本原因,也是这条路的终点所在。