
上周,觅蜂科技在上海办了一场发布会。会上,有两个数字给行业带来了一些惊喜。
第2万套MEgo无本体采集设备正式下线,MEgo全系列累计采集数据达到100万小时。
要知道,觅蜂科技是今年2月才成立的,团队只有几十人,用半年时间铺出两万套采集设备,同时形成百万小时的数据产能,这个速度值得关注。
尤其是两个数字要放在一起看。
两万套MEgo说明采集节点已经铺开,一百万小时数据则说明这些设备已经在真实场景里持续工作了。
MEgo是觅蜂自研的穿戴式数据采集设备。数采员戴着它,可以照常洗碗、配餐、擦桌子。人的劳动原本就会发生,MEgo负责把其中的动作、空间、触觉和声音记录下来。
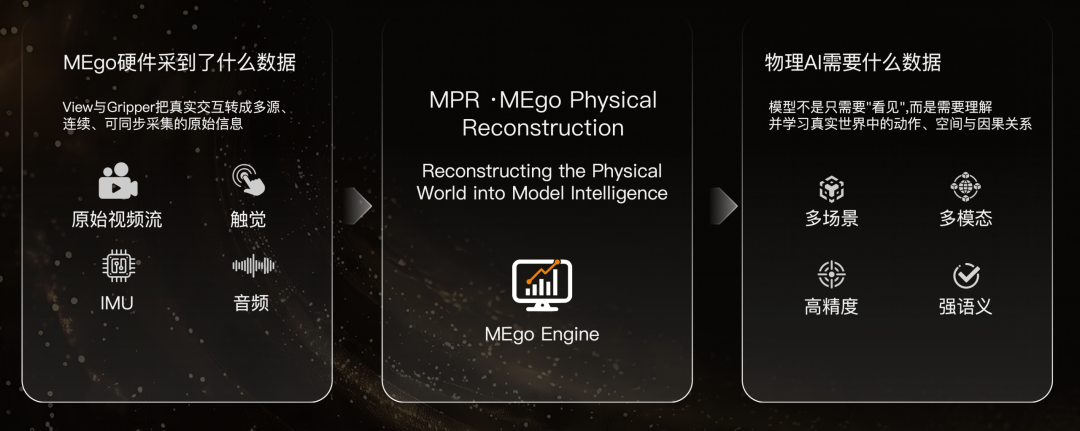
采回来之后,MPR物理重建系统和HandPose手部重建系统还要还原人与物体的空间关系,MEgo Engine再完成任务切分、动作标注和质量分级。
这些能力连在一起,觅蜂交付的就不只是一台采集设备,而是一套数据生产系统。
觅蜂科技董事长兼CEO姚卯青把MEgo比作物理AI数据电网的“电线杆”。“电线杆”立得足够多,真实世界的数据才有机会稳定流向模型。
01 数据生产,以人为中心
过去采集具身智能数据,通常要带着机器人本体。采集员通过遥操作控制机械臂,反复完成抓取、摆放和搬运。一个采集员对应一台机器人,想增加数据,就得继续购买本体、扩充场地、增加人手。
觅蜂选择以人为中心。它先记录人怎样自然地完成工作,再把这些动作转换成机器人可以学习的数据。这就是所谓“无本体数据”。
数据生产者也由少数专业采集员,扩大到每天在餐厅、工厂和家庭里真正做事的劳动者。
要做到这一点,设备不能妨碍正常干活儿。
MEgo是一套可以灵活组合的穿戴式采集系统。MEgo View由头戴和腕部模块组成:头戴设备记录整体环境,提供超过300度的感知范围;腕部设备跟着双手移动,近距离记录手与物体的交互。此外还有MEgo Gripper,通过夹爪记录物品的运动轨迹和触觉信息。
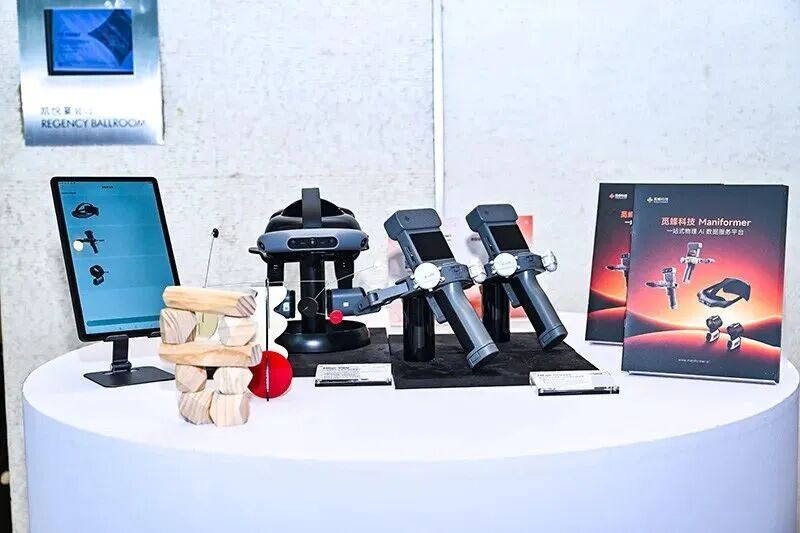
数采员戴好设备,就可以照常工作。多个模块无线互联并保持时间同步,不用背电脑、拖线缆。电池可以快速拆换,长时间作业不必停下来等待充电。
MEgo记录的也不是普通的第一视角视频。头部设备看整体,腕部设备追踪双手,深度和触觉传感器记录空间与接触状态。这些信息同步之后,后端才能还原一个动作具体是怎样发生的。
这种产品形态放进真实工作才有价值。比如,奶茶店员要连续拿杯、加料、封口,保洁人员要频繁弯腰、转身和移动。设备重一点,动作就会变形;使用麻烦一点,人就不愿意长期佩戴。
MEgo做对了一件事:尽量让佩戴者忘记设备。
人继续完成原来的工作,数据在过程中自然产生。过去,数据产能取决于实验室里有多少台机器人;现在,它开始取决于MEgo能够进入多少个真实工位。
两万套MEgo,也就成了两万个真实世界的数据入口。
02 一百万小时,把数据分层不浪费
数据采回来,只完成了第一步。
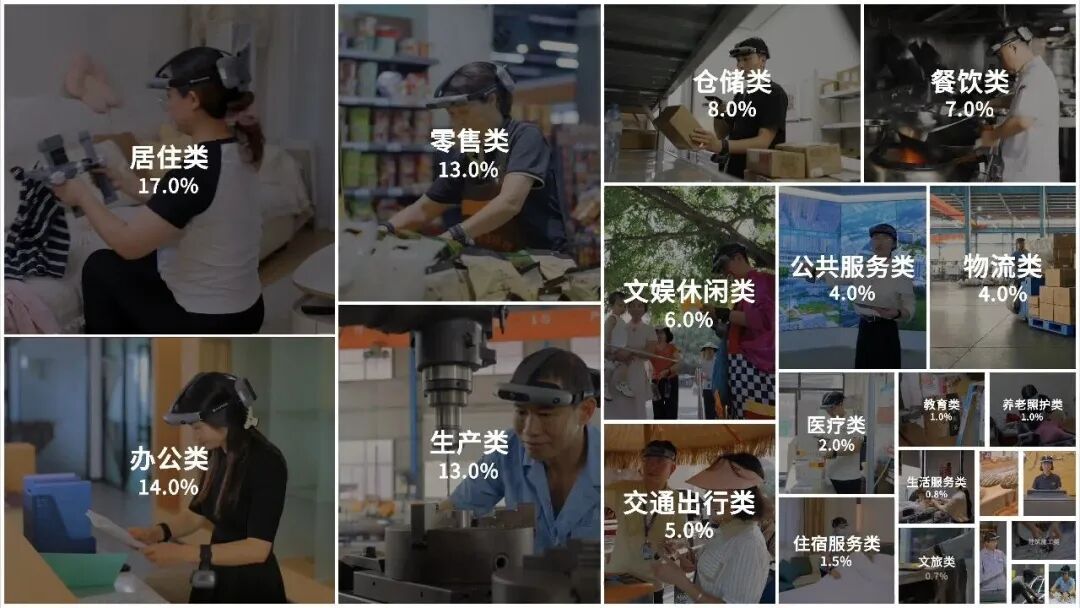
觅蜂这100万小时数据覆盖22个大类、500多个细分任务和5万多种物体,包含视觉、深度、触觉和音频。它们来自真实工作现场,而不是提前布置的实验环境。
真实数据越丰富,处理难度越高。
以制作一杯奶茶为例。人看到的是店员拿起杯子、加入原料、封口出杯;模型需要知道的却更具体:手从哪里接近杯子,手指什么时候闭合,杯子移动了多远,哪一步出现了停顿。
觅蜂先用MPR处理这些问题,你可以把它理解为一套物理重建系统。它把头戴、腕部和夹爪设备采集的内容放进同一个三维空间,还原人体、双手、工具和环境的位置与运动。
一段普通视频只能告诉模型“店员拿起了杯子”,MPR要还原的是手接近杯子、完成抓握、移动到操作台的完整轨迹。
其中,最难还原的是手部动作。
做美甲时,美甲师和顾客的双手不断交叉;制作奶茶时,杯子可能挡住七成以上的手;清洗宠物时,还会遇到泡沫、动物毛发和快速移动等干扰。
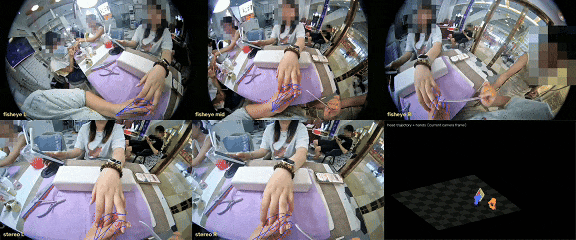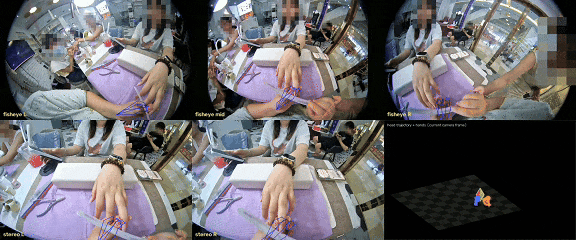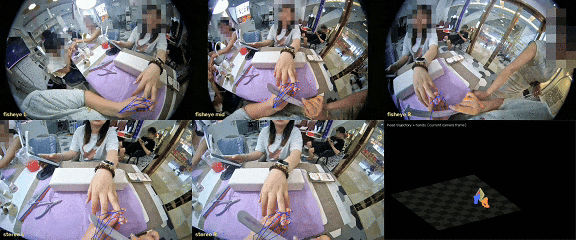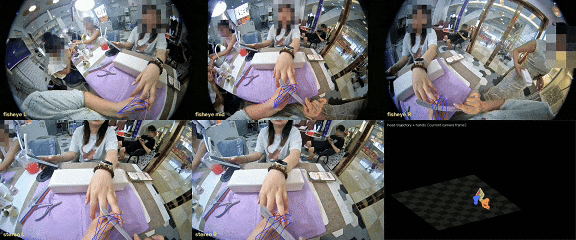
HandPose则是觅蜂开发的手部姿态重建系统。即使手暂时被杯子遮住,它也要把遮挡前后的动作接起来,避免轨迹中途断掉。这样,模型拿到的才是一次完整抓握,而不是几段互不相连的画面。
根据觅蜂公布的测试结果,HandPose在七项指标上达到行业领先水平。其中,手部关键点重建误差较业界次优方案降低62%,帧间抖动降低93%。手部只露出不到30%时,系统也能保持连续追踪。
动作还原出来,下一步就是告诉模型这段动作在做什么。
MEgo Engine是觅蜂的后端数据处理系统。它把两三个小时的连续作业切成不同任务,再拆成更小的动作。还是以制作奶茶为例,一段录像可以先按订单切开,再拆成取杯、加料和封口,人的运动轨迹也会被转换成不同机器人能够学习的形式。
完成切分后,数据还要经过觅蜂的质量评估系统ManiEval。一次准确的抓杯动作,可以教机器人模仿;杯子差点滑落、又被店员接住的动作,可以用于训练错误识别;手被严重遮挡的少见情况,则可以测试模型在复杂环境中的稳定性。
觅蜂把这套方法概括为“不过滤,只分级”。
真实工作中,人会失误,也会返工。如果把这些片段全部删掉,机器人学到的仍然是一个过于干净的世界。
觅蜂选择保留它们,再按照不同用途分层。一百万小时数据因此可以用于预训练、动作学习、错误识别和模型评测,而不是只用一次就失去价值。
采得多,说明觅蜂有产能;能够还原、切分和分级,才说明这些数据正在变成可以反复使用的资产。
03 从「设备生意」走向「数据基础设施」
采集设备只有接上处理系统和模型需求,才可能成为基础设施。
觅蜂已经把这条链路接了起来。前端设备进入真实场景,工作人员在正常劳动中产生数据;后端系统完成重建、切分和分级,处理结果再交给模型团队。目前,这批数据已经开始服务腾讯旗下机器人实验室Robotics X、蚂蚁灵波等研发团队。
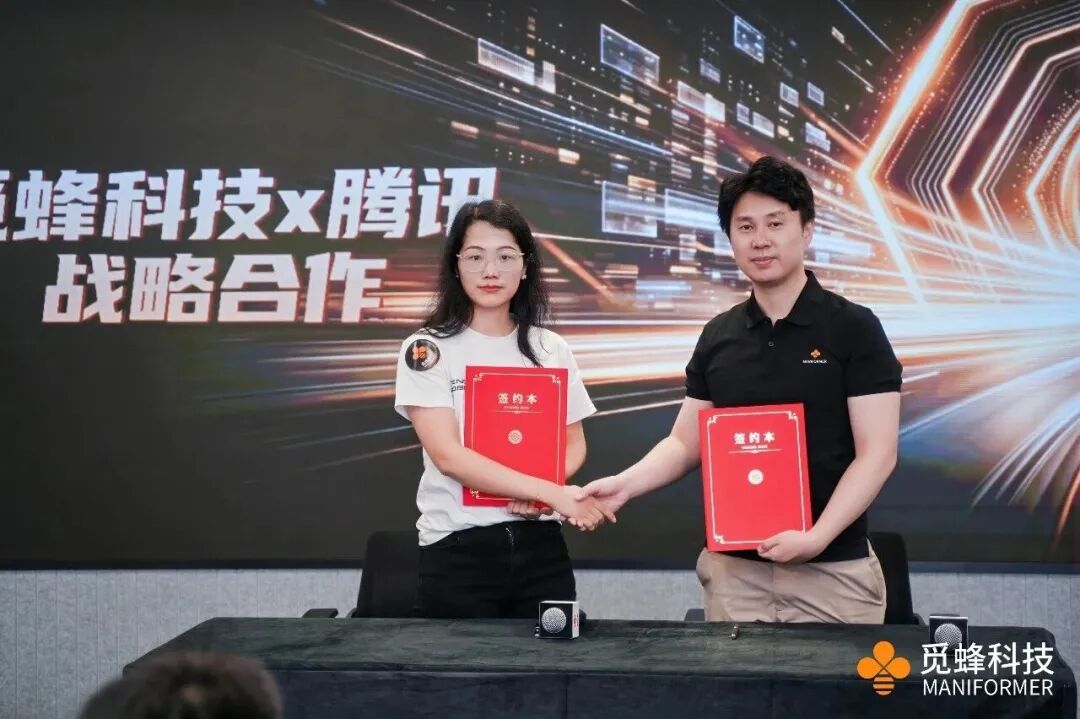
腾讯Robotics X实验室产品生态负责人朱亚娟从模型端给出了评价:无本体数据能帮助模型理解物理世界、适配不同机器人,也能在一定程度上替代过去依赖机器人本体的遥操作采集,“对我们来说特别重要”。
这让觅蜂有机会走出一次性硬件交付,转向持续的数据供给。
与互联网时代的数据标注不同,物理AI的数据生产不能只在电脑前完成。它必须进入餐厅、工厂和家庭,记录人与真实物体的交互。谁能稳定进入这些场景,又能把采回来的内容处理成训练材料,谁就有机会成为模型与现实世界之间的数据接口。
觅蜂已经铺出了两万套设备,也建立了百万小时数据的处理能力。这是公司目前最有价值的积累。
姚卯青还提出,觅蜂的数据采集会从集中式走向半集中式,最后走向全民众包。未来,数据不再只由专业团队生产,普通人也可以在日常工作中参与。更多真实工位接入之后,稀缺的长尾动作也会逐渐进入训练数据。
第一根电线杆已经立住。设备在真实场景里采集,后端持续处理,模型团队也开始使用。以觅蜂半年跑出的速度看,这张物理AI的数据电网,已经开始铺开。
— 欢迎您在评论区跟我们交流 —