作者|苏涵
最近结束的世界人形机器人运动会,又把机器人的能力往前推了一步。
赛场上,机器人跑得越来越快,百米最快成绩已经来到 8.64 秒,比博尔特的世界纪录还快了将近 1 秒。但离开赛场,进入真正的工厂,情况却没有这么乐观。
路透社近期走访中国机器人产业后发现,一些机器人完成简单任务的效率仍只有人类的 20% 左右。在汽车产线上,传统机械臂依然承担着大量关键工序。机器人距离稳定工作,还有很长的路要走。
这也让具身智能的竞争逐渐从「身体」转向「大脑」。
过去两年,VLA 被视为机器人走向通用智能的重要路径。
今年以来,世界模型、WAM 又迅速升温。
行业试图解决的其实是同一个问题:为什么机器人在训练中表现很好,一旦换个物体、角度或者环境,就容易失灵?
甚至宇树科技创始人王兴兴近期也判断,机器人的「ChatGPT 时刻」还没有真正到来,接下来更关键的突破仍在软件和智能能力。
8 月 25 日,光象科技联合清华大学李升波教授课题组发布第一代物理原生世界模型 Phi-WM 1.0 ActEffect,把关注点放到了另一个长期被忽视的问题上。
在光象科技看来,今天机器人的问题并不只是能不能学会一个动作,还在于它是否真正理解动作与环境变化之间的关系,也就是理解「这样做之后,会发生什么」。
这也带来了另一个问题:目前机器人的「大脑」还缺什么?光象科技选择从「动作与后果」入手,寻找答案。
更多数据之后,机器人还缺什么?
这几年大模型已经证明了一件事:更多数据、参数,可以不断推高模型能力的上限。
到了具身智能,大家也希望复现同样的路径。
今年 8 月,Dyna Robotics 发布 Dyna-2,用超过 100 万小时的人类第一视角视频进行预训练,并观察到了从人类视频数据向机器人任务迁移的 Scaling 规律。
但相比互联网,机器人能够获得的数据仍然太少。
路透社近期援引行业估算称,目前具身智能行业积累的高质量训练数据大约只有 50 万小时,而一些业内人士认为,真正走向更高水平的物理智能,可能需要上亿小时的数据。
这种差距,也让「更多数据」成为今天具身智能最直接的答案之一。
在光象实验室首席科学家吕尧看来,现在很多具身模型只有几 B 参数,并不意味着机器人不需要更大的模型。一个现实原因是,现阶段的数据还不足以把更大的模型「喂饱」。
如果未来机器人需要处理更多物体、更复杂的环境,甚至进入开放世界,模型规模仍然需要继续增长。
物理世界的信息密度和复杂程度,也决定了具身基础模型最终可能需要比今天更大的容量。
与此同时,机器人如何理解物理世界,也成为行业正在探索的另一个问题。
语言模型说错一句话,重新生成一次就可以了。机器人不一样。它面对的不是一个可以不断刷新答案的数字空间,每一个动作都会在真实世界留下结果。
吕尧把这个问题概括成了「99% 到 100% 的鸿沟」。
以视频生成式世界模型为例,随着数据和算力继续增加,生成结果可以越来越逼真。但对于机器人而言,99% 的正确和 100% 的可靠之间,仍然可能隔着很远。
因为剩下的 1%,在视频里可能只是一个不容易察觉的错误;到了物理世界,却可能决定一次抓取究竟成功还是失败。
目前,VLA 模型已经让机器人向前走了一大步。但大量训练数据告诉机器人的,更多是人类在某个时候「做了什么」。机器人能否进一步理解环境如何变化、动作又会产生什么影响,行业还在寻找答案。
今年以来,越来越多研究开始尝试把世界预测和动作生成放在一起,WAM 也由此成为具身智能一个快速升温的方向。
相比直接从观察映射到动作,它希望模型能够进一步预测环境如何变化,再把这种预测用于机器人的决策。
但问题还可以继续往前追一步。
如果世界模型能够生成一段足够逼真的未来视频,是不是就意味着机器人真正理解了物理世界?
光象科技对此有自己的判断:「描述世界,并不需要刻画所有细节。」
吕尧认为,对于机器人来说,重要的不是把未来每一个像素都生成得足够逼真,而是抓住那些真正影响任务的物理信号。
一只杯子有没有被抓稳,一个零件会不会因为受力发生位移,一次动作之后物体的状态会如何变化,这些信息未必需要一段高度逼真的视频才能表达。
沿着这个问题,光象科技把注意力放到了动作与环境变化之间的关系上:机器人能不能理解,自己的动作会带来什么后果?
ActEffect 就从这里出发。
从预测未来到理解后果,光象科技换了一种世界模型思路
当前,行业里具身智能最常见的训练方式,依然是让机器人看大量正确示范。
但这些数据有一个共同点:它们大多告诉机器人,什么是「对的」。至于做错会怎样,数据里很少有答案。
举个例子,如果机器人要夹起一个杯子,夹爪提前闭合会怎样?从另一个角度抓会怎样?力度大一点,杯子会不会滑动?
同一个场景下,机器人其实有很多种动作选择,但示范数据通常只留下了其中一条成功路径。
对于这个情况,吕尧认为「影响能力上限的数据,是在仿真环境中大量试错、进行反事实推理的数据。」
所谓反事实,就是把时间拨回机器人执行动作之前,让它面对完全相同的场景。
第一次向左抓,第二次向右抓,第三次换一个角度,第四次改变力度。每一种动作,都会把世界推向不同的结果。
对机器人来说,这些结果本身也是数据。然而,真实环境也很难做到每次完全复位,仿真环境反而更适合做这件事。
按照光象科技的判断,要让机器人真正学会状态如何随着动作变化,这类反事实数据未来可能需要达到真实成功示范数据的 10 倍甚至 100 倍。这也是 ActEffect 的出发点。
过去不少世界模型更像一个「预见者」,机器人准备行动之前,先预测接下来可能出现的世界状态,再根据预测结果决定应该怎么做。ActEffect 则换了一个位置,它更像一个「反馈器」。
它要求的是机器人先提出动作,世界模型再去判断:如果真的执行这个动作,接下来会发生什么?这样一来,训练的重点发生了变化。机器人不再只需要回答「这个时候应该怎么做」,还要逐渐学会判断「哪种做法带来的结果更好」。
官方将这种变化概括为从「推理时规划器」转向「训练时反馈器」。
这个变化还带来了另一个结果。
训练完成之后,ActEffect 会把受控世界模型从推理链路中移除。
也就是说,机器人真正开始工作时,不需要每做一个动作,都重新调用世界模型预测一遍未来。
训练阶段反复比较动作和后果形成的能力,已经被学习进策略模型。部署时,机器人看到当前环境,可以直接生成动作。这件事看起来只是模型结构上的调整,背后却有一个很现实的问题:成本。
实验室里跑一个机器人,模型多算几次,可能并不明显。但机器人真正进入工厂以后,情况完全不同。
一台变成十台,十台变成一百台。
每台机器人每天运行十几个小时。
每一次动作都增加一段世界模型推理,最终增加的都是算力、延迟和部署成本。
所以,光象科技把更复杂的「思考」尽可能留在训练阶段,希望部署时的推理链路保持轻量。
从已经公开的实验结果看,这套方法取得了一些不错的成绩。
ActEffect 在 LIBERO 上的平均成功率达到 98.8%,在加入相机、光照、背景、布局等分布扰动的 LIBERO-PLUS 上达到 80.3%,在更复杂的 RoboCasa-GR1 上达到 67.5%。
消融实验中,去掉后果反馈后,LIBERO 成功率从 98.8% 下降到 97.0%。
但这些数字还不能回答所有问题。
目前 ActEffect 公开的主要结果,仍然来自 LIBERO、LIBERO-PLUS 和 RoboCasa-GR1 等 Benchmark。
光象科技自己也把下一步说得很明确:接下来要把这套方法放到更广泛的真实环境,以及更复杂的长程任务中继续验证。
具身智能真正的「一把火」,要在真实场景里点燃
模型最终还是要走出实验室的。过去几年,行业习惯用跑、跳、抓取和 Benchmark 衡量机器人的进步。
到了现在,随着越来越多机器人已经开始进入汽车、3C、物流等真实场景,另一套评价标准正在变得重要:节拍、精度、连续运行时间、部署成本和 ROI。
然而,真正到了生产线上,传统自动化依然占据绝对主流。
对于固定轨迹、标准物料和高度重复的任务,一台传统机械臂往往已经足够成熟。
路透社近期走访中国机器人产业时发现,在一些简单任务中,机器人目前的效率甚至只有人类的 20% 左右。
面对真实工厂里物体、光照、角度、表面状态等细微变化,机器人依然很容易失灵。
显然,很多简单的搬运流程,仅靠传统自动化已经能够解决。
真正适合具身智能的,是环境变化、物料不规则、需要感知和实时决策的「剩余难题」。
对此,光象科技创始人兼 CEO 张涛指出,「过去很多人做机器人搬运箱子,我们之所以不做,是担心做完之后发现其实没有价值。」
原因不是搬箱子没有需求,而是「已经存在更便宜、更简单、更成熟的方案」。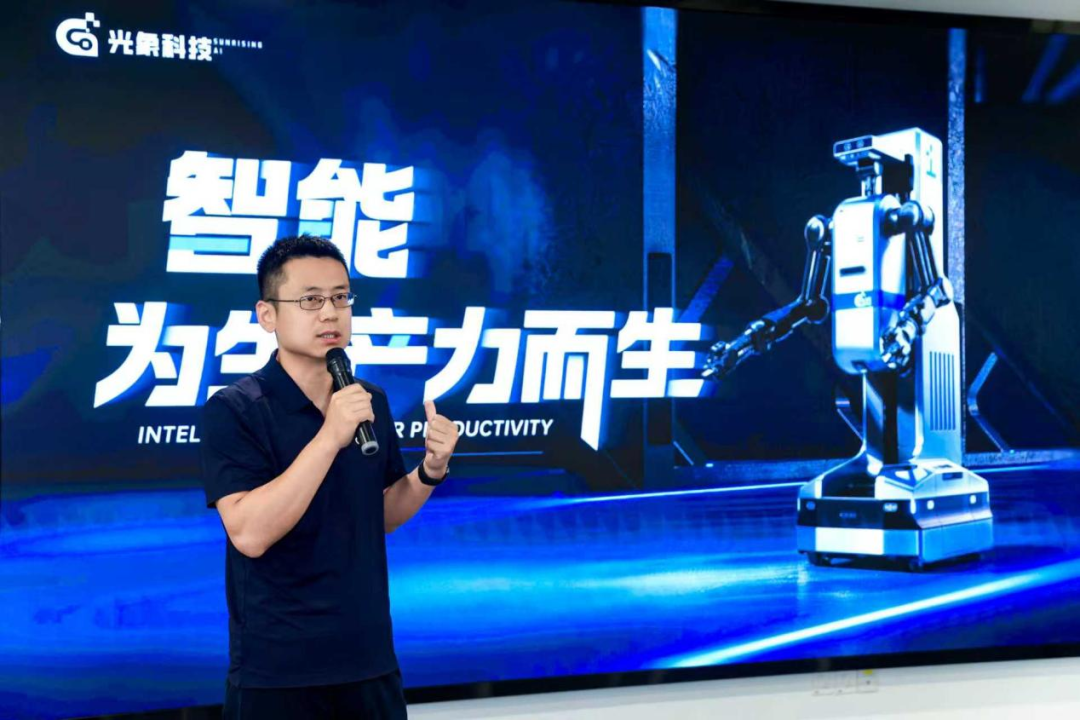
所以光象科技给自己定了一个标准:去找那些传统自动化没有很好解决的问题。
汽车制造成为它最先进入的场景,移动质检就是其中一个典型工位。
汽车表面是连续变化的曲面。机器人一边移动,一边调整底盘、腰部和机械臂,还要让视觉系统持续覆盖需要检测的位置。
按照光象科技此前公开的数据,Phi-Bot X1 在移动质检中,相比非协同方式效率提升 51%,较人工工位节拍节省 25% 至 45%。
在焊接上下料场景中,它则需要完成抓取、移动、翻转、精准对孔、放置等一整套长程任务。
这些场景并没有搬箱子那么直观,却更接近具身智能真正需要解决的问题。
张涛此前谈到工业落地时,也把判断标准说得很直接:「机器人能不能用,核心还是看价值。」
对于工厂来说,这种价值最终无非落到几个指标上:成本有没有下降,效率有没有提高,质量有没有改善,或者能不能把人从高风险、高劳损的工位上替换下来。
但找到一个有价值的工位,只是第一步。
一套方案在一个工位训练几个月,最后终于跑通,可以证明技术可行。
但如果换一条产线或者任务,又需要重新采集数据、重新训练、重新部署,那么它依然很难形成真正的规模。
所以,模型 Scaling 之外,具身智能还面临另一个很现实的问题:部署能不能 Scaling?
对机器人公司来说,复制能力会直接决定商业模式。每增加一个工位,如果都要重新采集大量数据、重新训练模型,成本也会跟着线性增长。
真正有价值的泛化,最终要体现在部署上。光象科技也在试图缩短这个过程。
张涛透露,一个典型工位目前的部署过程大约需要一周,未来希望进一步压缩到以天计算。Phi-Bot X1 发布时,光象给出的目标也是把传统工业自动化动辄数月的部署周期,缩短到周级甚至天级。
一旦同样的能力能够快速进入不同工位、不同工厂,成本还能算得过来,才开始接近真正的产品。
当然,这距离真正的大规模部署还有距离。
过去几年,具身智能一直在等待自己的「GPT 时刻」。人们期待某一天,一个足够强大的模型突然出现,让机器人拥有真正的通用大规模部署能力。
但物理世界的变化,很可能不会以这样的方式发生。
张涛曾把具身智能真正实现规模商业化,比作行业需要的「一把火」。
这把火会从哪里点起来,现在还没人知道。但有一点正在变得清楚:第一批真正跑出来的应用,需要解决过去机器解决不了的问题,还要把效率、成本和可靠性同时做到工厂能够接受的水平。
光象科技把第一站放在汽车工厂,焊接上料、移动质检只是其中两个工位场景。
这两个工位跑通以后,还要看第三个以及更多;一家工厂跑通以后,还要继续复制到更多工厂。
这个过程不会像机器人跑出一个百米纪录那样醒目,却更接近具身智能真正进入产业的方式。
过去几年,机器人已经一次次证明自己「能做到」。
接下来,行业需要证明的是,这些能力究竟能不能更好地留下来。