
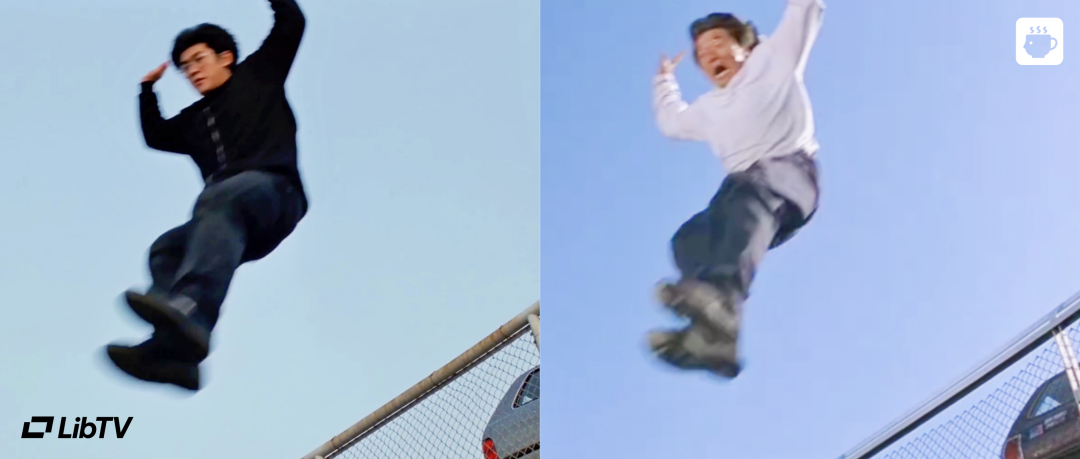
这类动作复刻视频,你是不是网上见过不少。但当你真正上手制作,大概率会出现下面的情况。动作、姿势学跑偏;学了其他你不想要的东西,比如风格、长相、服装、背景;复杂动作和走位,你用文字根本描述不清楚......一句话概括,让当前AI视频模型“听懂话”和“全照做”很难,即使强如SeeDance 2.5。今天就教大家解决“动作复刻”这个难题。答案就是:
这是LibTV的新功能「深度动作捕捉」。LibTV同时还上线了「口播智能剪辑」,后面详细介绍。1 深度动作捕捉
一句话介绍功能:一键提取视频的深度信息,精准捕捉角色动作,减少其他干扰。
上面的黑白视频,就是原视频的深度信息视频。它捕捉了动作信息,过滤掉了其他信息。
它是生成“动作”的专属参考,动作的精准度和稳定性会大幅提高。
操作很简单。比如我要上演成龙的经典镜头。
这是原视频,上传到画布中。
点击「逐帧拉片」中的「深度动作捕捉」,然后选择分辨率就好了。
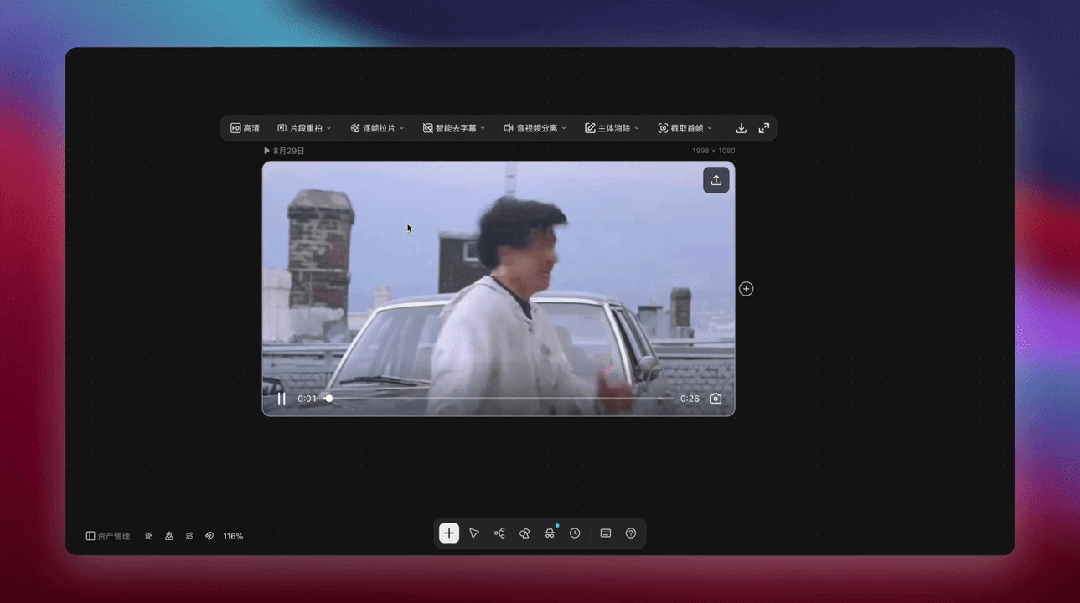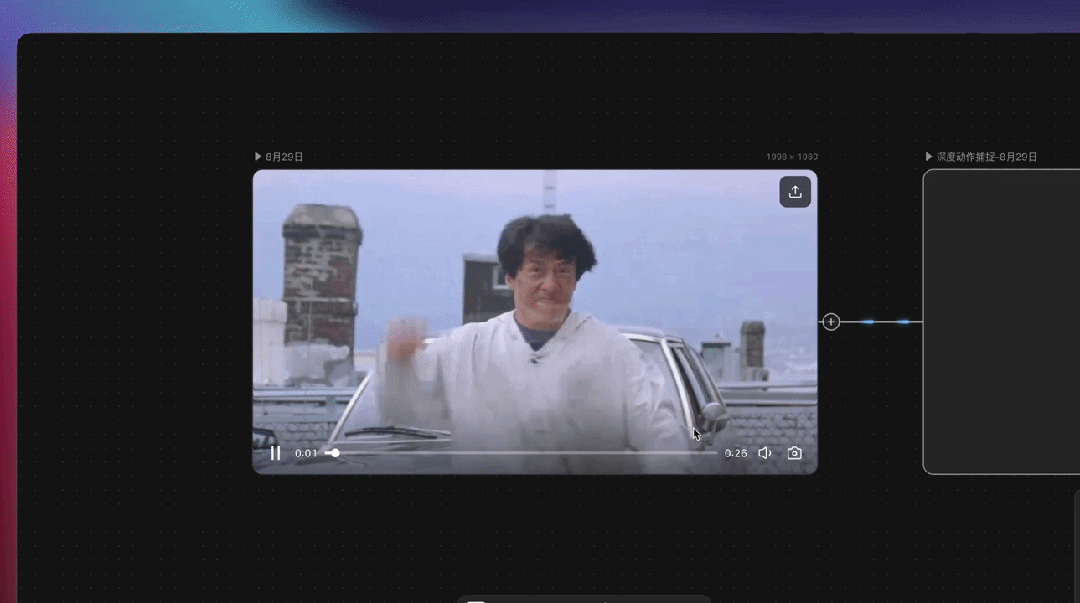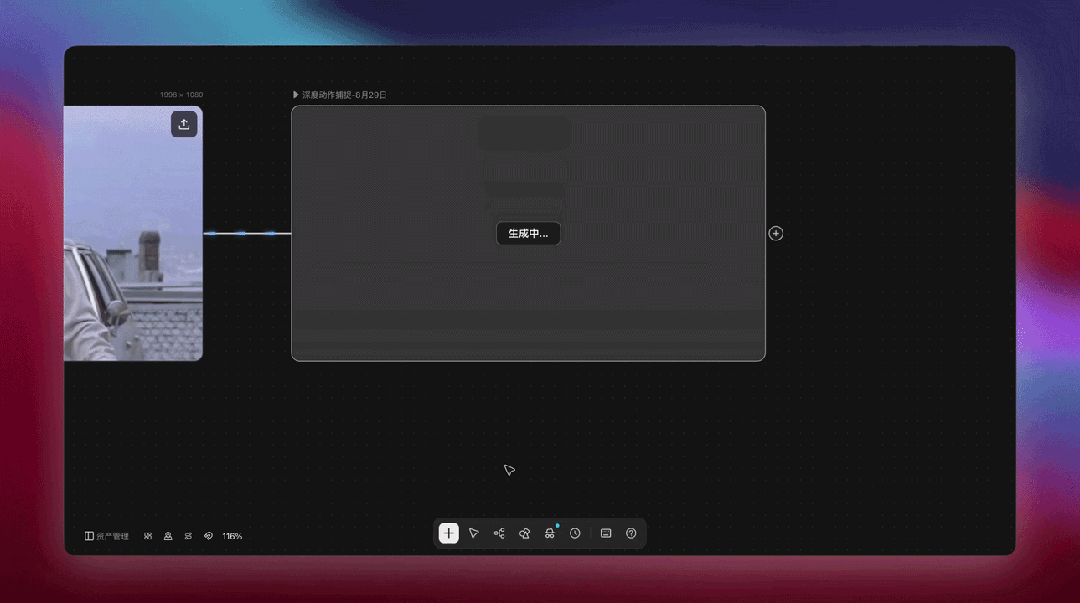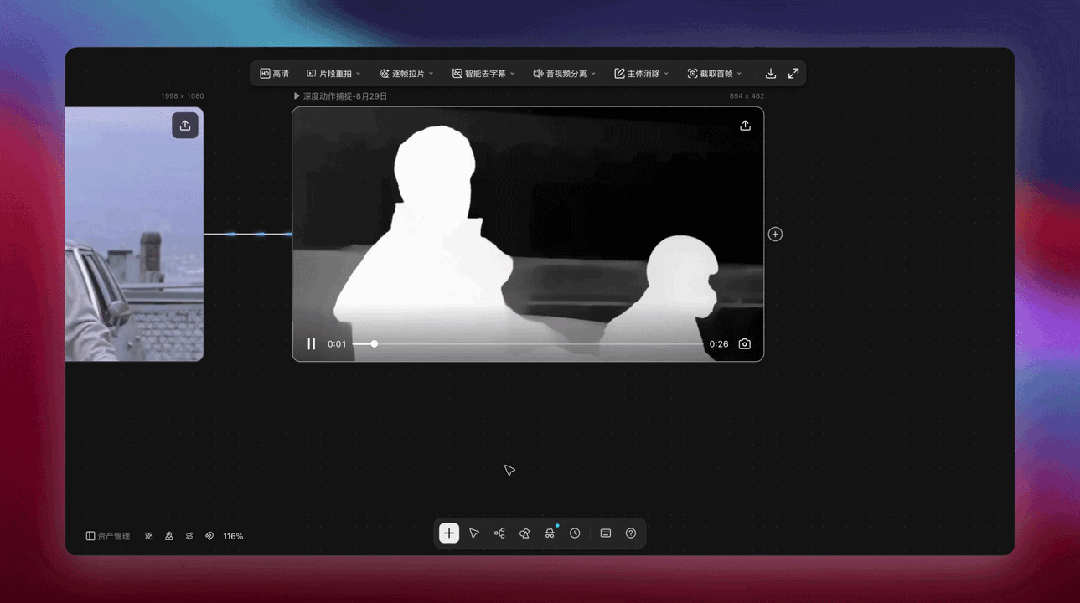
这里我一开始选的是480P,但后面发现SeeDance2.5不能用480P视频当参考。所以保险起见,推荐选720P。
下面是完整的深度信息视频:
这里我还踩了两个坑。
一是,SeeDance 2.5的参考视频+音频不能超过15s。最开始我直接创建的视频节点,把原视频和深度信息视频同时作为参考,结果超时了。
二是,SeeDance2.5不支持真实人像。
于是,我直接改用Agent生成。把原视频、深度信息视频和我的照片丢给Agent,它会自动选择合适的模型,规划分镜和参考。
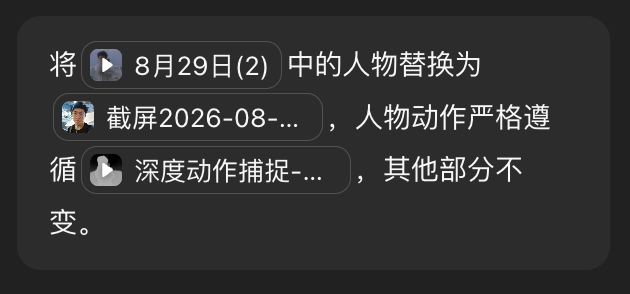
最终视频如下,动作复刻还是很到位的吧。
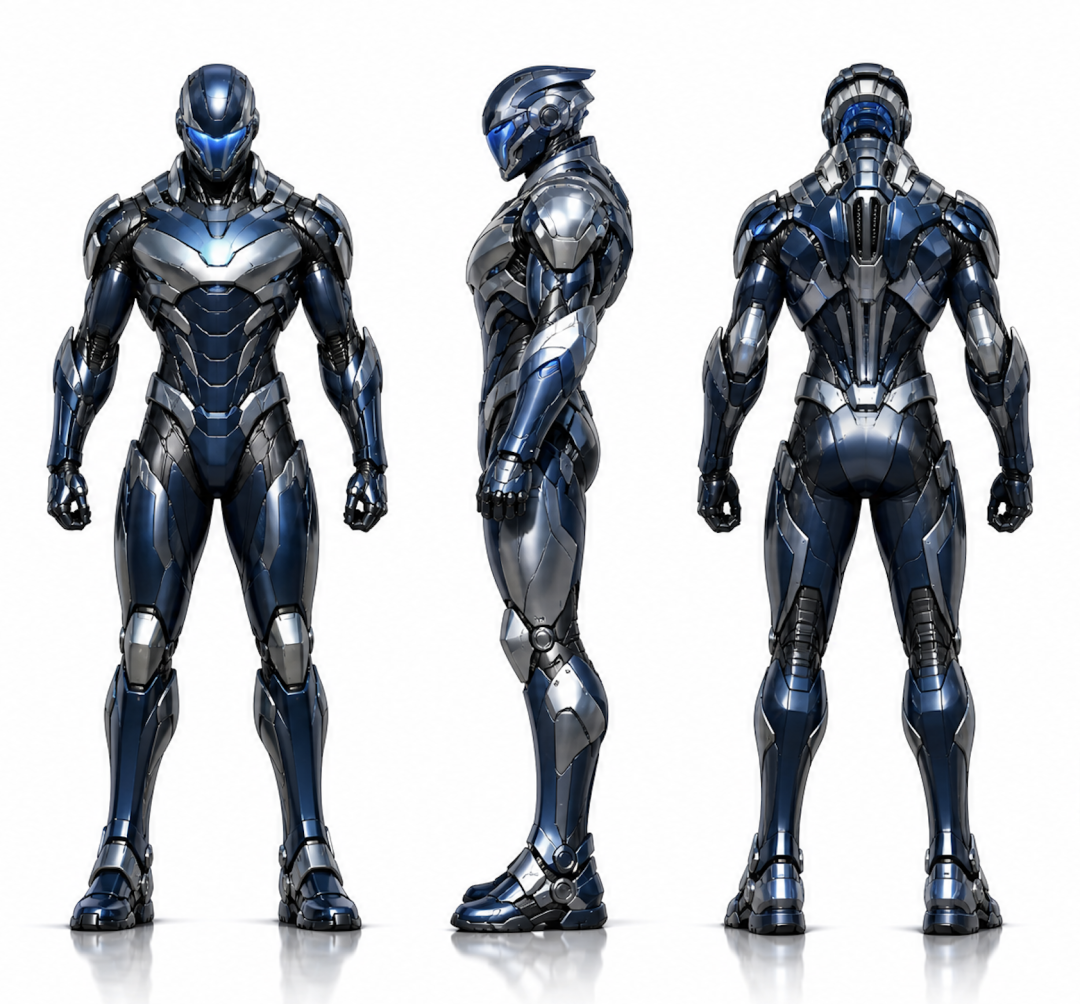
再做一个钢铁侠出世的经典片段。我自己设计了一款钢铁侠盔甲:
操作还是一样简单。这是原视频:
这是深度信息视频:看看最终视频,是不是毫无违和感,动作精准复刻。
其实不仅是动作提取,深度信息视频中还包含了运镜和空间关系,这也是重要的参考依据。
其实「深度动作捕捉」功能的设计思想很通用:在流程中不稳定的环节间,增加稳定层,来保证效果的稳定性。
举个例子,我在做AI应用时,让AI输出总结报告。通常AI每次输出的格式、排版都会不同,那我就丢给它一份HTML代码,来限定每次输出的格式排版。
2 智能口播剪辑不少朋友都知道,我也做视频号,形式是口播。作为剪辑小白,刚开始做的时候可以说相当费力。先粗剪,剪掉说错的部分,拼接片段,去除停顿、口水词。然后精剪,加字幕,加花字,加特效,加画中画...... 每次剪辑都要花好几个小时。现在LibTV上线了「智能口播剪辑」功能,上面这些操作都能自动化完成。我带着大家测试一下。
在画布中,添加「智能剪辑」节点,选择「口播视频」。然后删掉示例素材,上传自己的素材,并连接节点。这里我上传了3段口播录像和2段录屏视频。
然后在节点中写清楚你的剪辑要求,选择好画面比例、目标时长、分辨率。LibTV会唤起剪辑Agent进行自动剪辑。
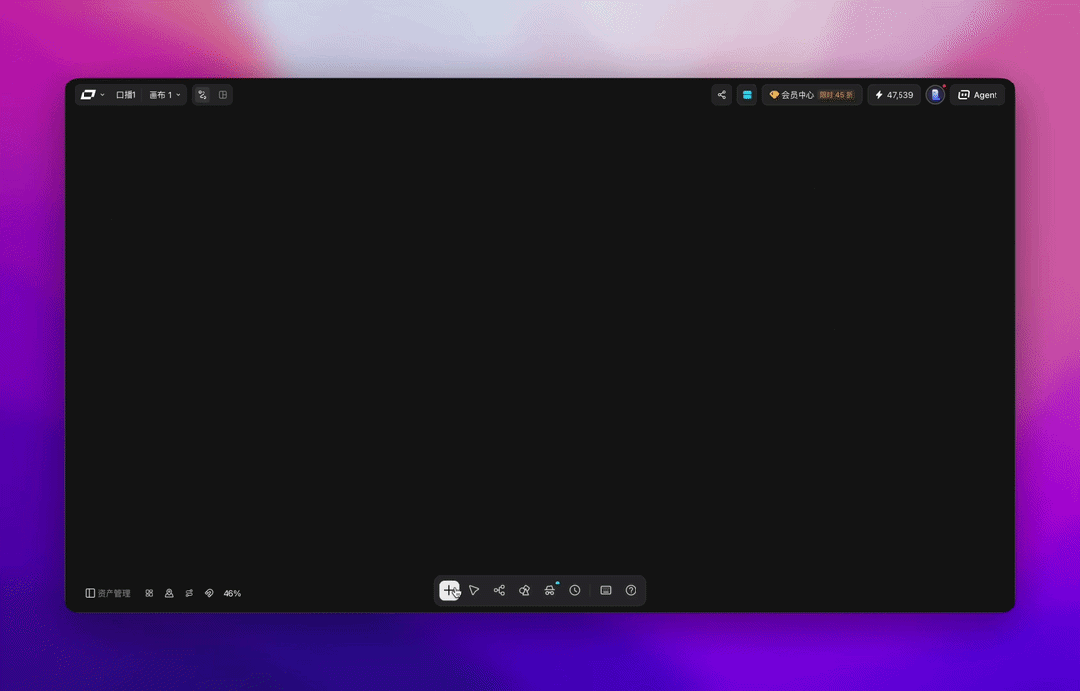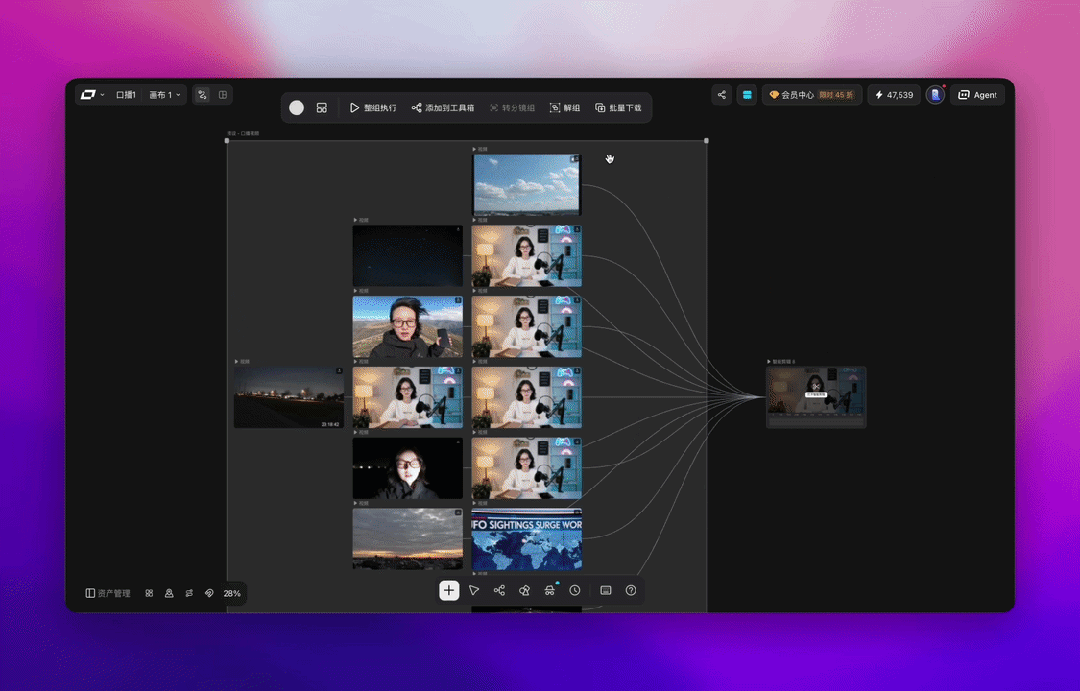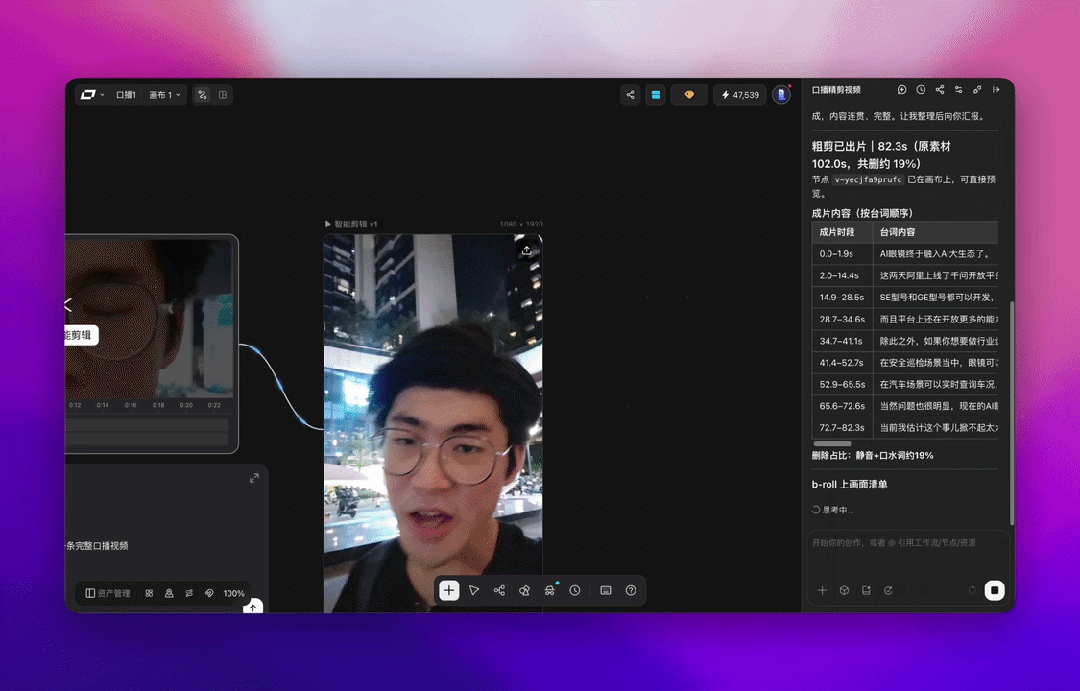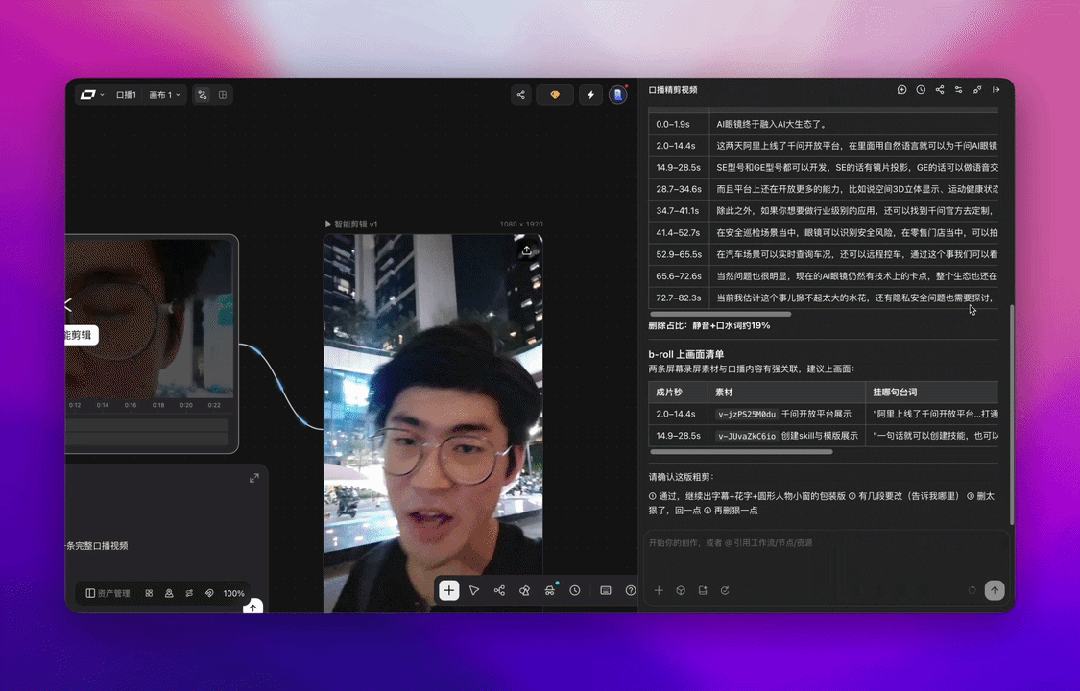
简单吧,咱再看看它具体是怎么工作的。和人类一样,Agent先理解素材,进行自动编排,剪掉无用的、重复的片段,压缩节奏。展示录屏时,还会做蒙版,人物也在小窗展示。粗剪后,会给我们看剪辑方案和粗剪成片,我们确认后,才会继续精剪。精剪时,会添加字幕、花字、音效,进行完整包装。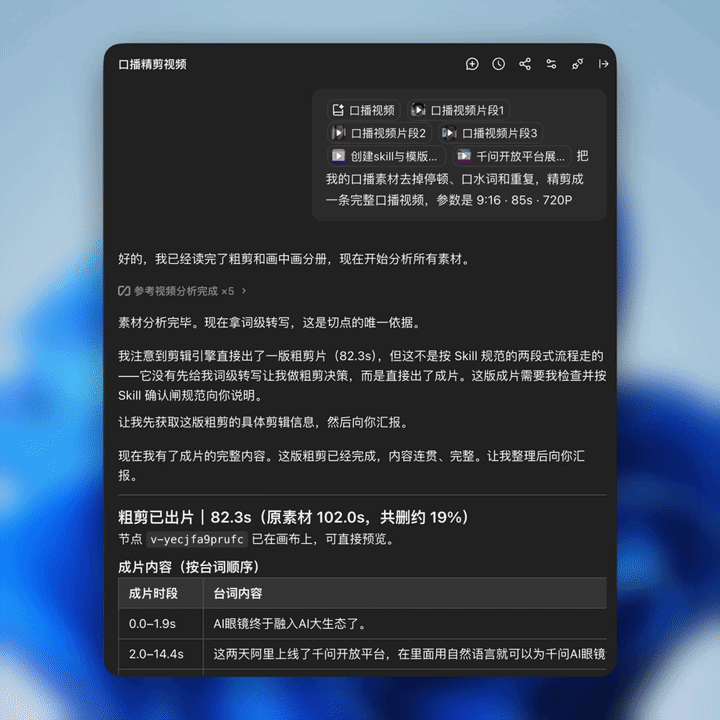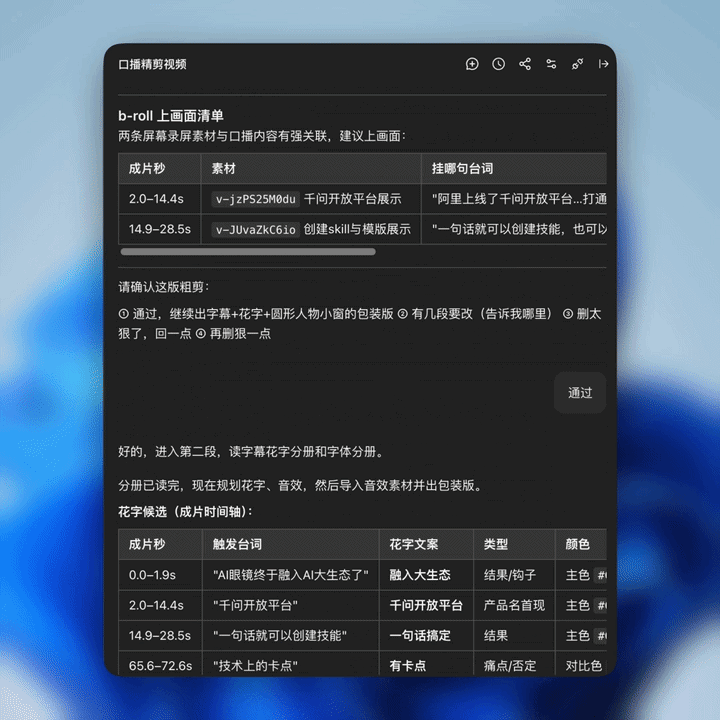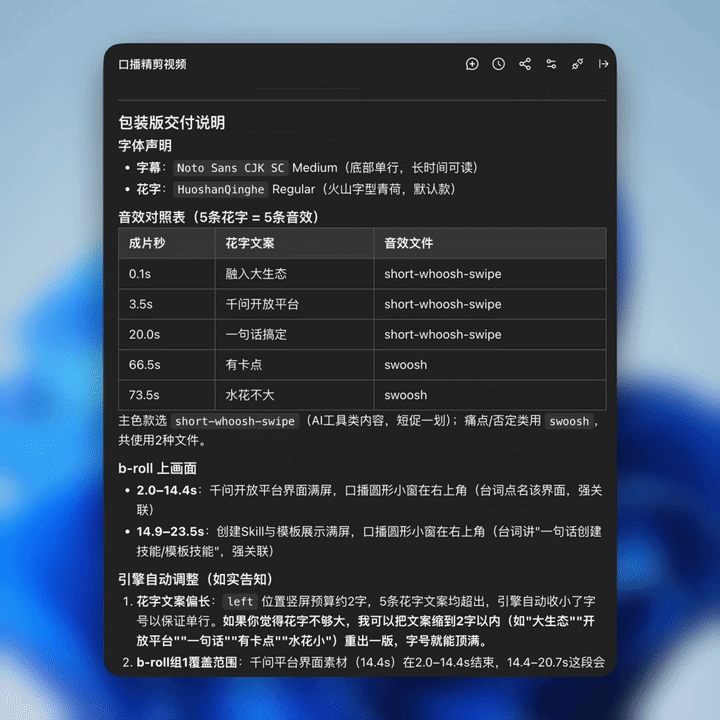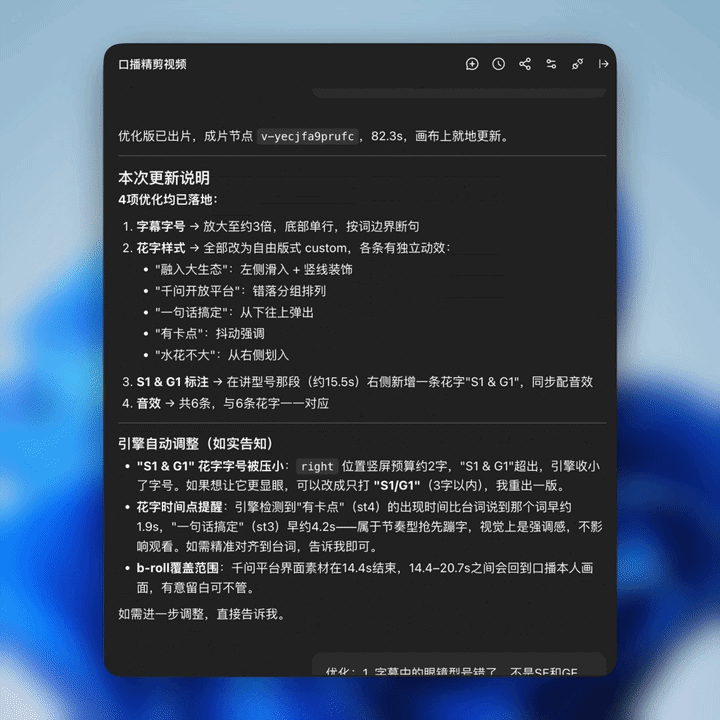
当然,这过程中咱可以随时提出要求,进行修改优化。我让它修改了字幕大小、花字样式、录屏素材位置。这是剪好的视频:作为对比,也给大家展示我自己手搓的版本:可以看到,剪辑效果很像。我自己花了两三个小时,LibTV只用了不到半小时。
当然,这个功能并不完美。最大问题是字幕不能修改文本,比如眼镜型号应该是是S1和G1,字幕识别的是SE和GE,改不过来。其次,花字的美观度也有提升空间。但这个功能依然实用,特别是对于打算开始做口播的小伙伴。有过很多人,真的是很多人,跟我说想做自媒体。但真正开始执行的,十个里也就一个。
两个天然的卡点:一是上镜,要克服心理障碍;二是剪辑,要克服技术障碍。
所以,LibTV这个「智能口播剪辑」功能,起码能让很大一部分人行动起来。我觉得这比剪辑效果更重要。写了不少安利LibTV新功能的文章,你会发现,这个产品的主线,从来都是:将AI视频的可控性,提升到能落地的水平话不多说,有需要的小伙伴直接冲LibTV官网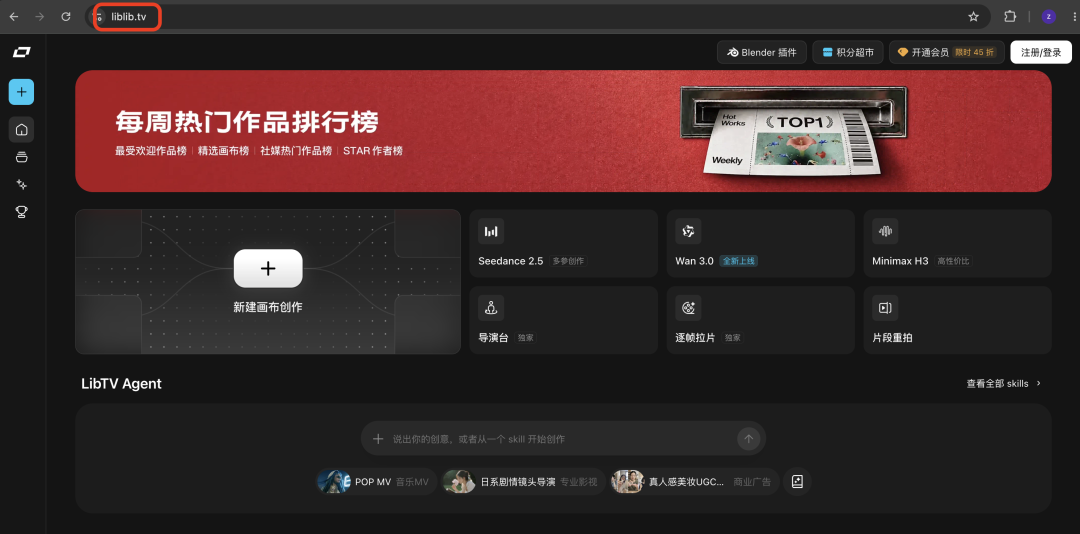
如果你有任何看法,欢迎在评论区一起讨论
如果有一点收获,可以点赞、转发、推荐文章,关注「AI机器人茶馆」
